언어 모델은 지시에 나온 낱말을 다음 글을 고르는 단서로 쓰기 때문에, 「코끼리 이야기는 하지 마」라고 하면 「코끼리」라는 낱말 때문에 오히려 코끼리 이야기가 나오기 쉽습니다. 모델이 부정 표현을 놓치는 경향은 여러 연구에서 확인되었으므로, 하지 말아야 할 일보다 해야 할 일을 적는 편이 정확합니다.
언어 모델은 앞에 놓인 글을 보고 이어질 낱말을 고르는 방식으로 글을 쓰는 AI 모델입니다. 그래서 지시문에 적힌 낱말은 뒤에 「하지 마」가 붙어 있어도, 그 낱말과 관련된 글이 이어질 가능성을 높이는 단서가 될 수 있습니다.
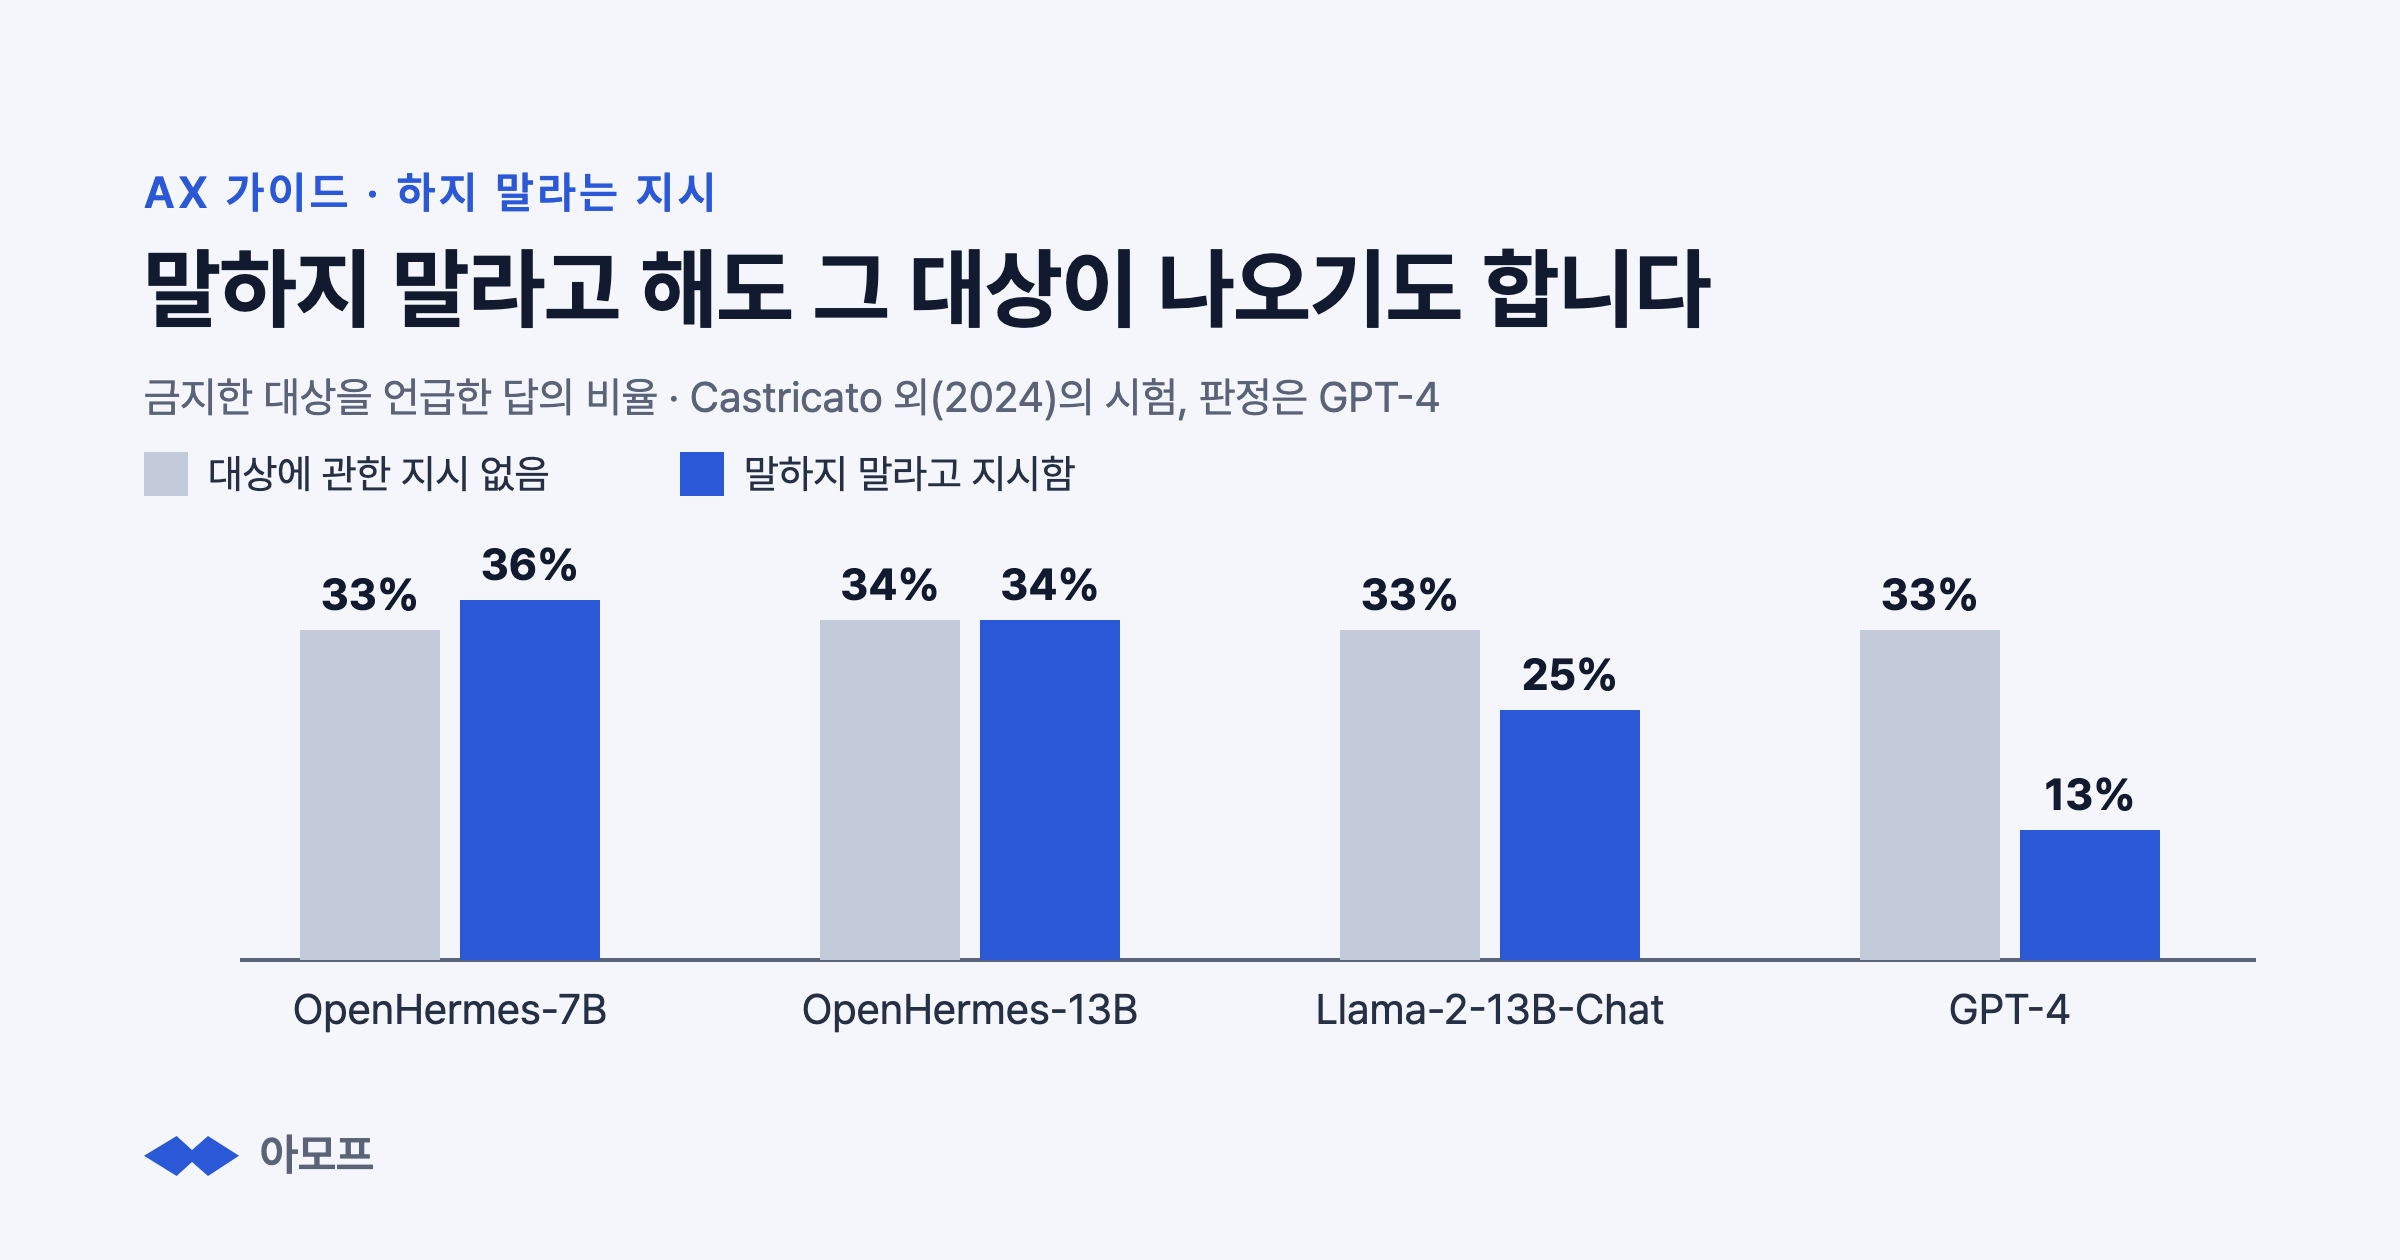
2024년 2월 공개된 연구에서 대화 중에 특정 대상을 말하지 말라고 지시하자, 모델의 답 가운데 그 대상을 언급한 답의 비율이 지시가 없을 때의 33~34%에서 OpenHermes-7B는 36%로 오히려 올랐고, OpenHermes-13B는 34%로 그대로였으며, Llama-2-13B-Chat은 25%, GPT-4는 13%로 내려갔습니다(Castricato 외, 2024).
하지 말라고 한 내용이 오히려 답에 나오는 까닭은 무엇인가요?
모델이 「하지 마」라는 부정 표현은 놓치고, 금지한 낱말은 다음 글의 단서로 쓰기 때문입니다. 앞의 연구진은 이 현상을, 무언가를 떠올리지 말라고 하면 오히려 그것을 떠올리게 되는 심리학의 「분홍 코끼리 효과」에 견주어 「분홍 코끼리 문제」라고 불렀습니다(Castricato 외, 2024).
이 시험에서 모델이 금지한 대상을 언급했는지는 GPT-4가 판정했고, 연구진이 일부를 직접 확인한 결과 사람의 판정과 94.5~98.5% 일치했습니다. 연구진은 언급을 피하도록 따로 학습시킨 OpenHermes 모델에서 지시 뒤의 언급 비율을 15~17%로 낮췄는데, 이는 지시문만으로는 잘 고쳐지지 않는 행동을 학습으로 고친 결과입니다(Castricato 외, 2024).
더 작은 예전 모델에서도 같은 경향이 보였습니다. 2020년 학회 ACL에서 발표된 연구는 BERT 같은 사전 학습 언어 모델이 「새는 날 수 [ ]」와 「새는 날 수 없[ ]」처럼 부정 표현만 다른 빈칸 문제를 잘 구별하지 못하고, 「말하다?」처럼 앞에 엉뚱한 낱말 하나를 붙이기만 해도 그 낱말을 따라 엉뚱한 답을 내기 쉽다고 보고했습니다(Kassner·Schütze, 2020). 연구의 원래 예는 영어 문장 「Birds can [MASK]」와 「Birds cannot [MASK]」, 「Talk? Birds can [MASK]」입니다.
하지 말라는 지시를 해야 할 일로 바꿔 쓰면 무엇이 달라지나요?
모델이 단서로 쓰는 낱말이, 원하지 않는 결과를 가리키는 말에서 원하는 결과를 가리키는 말로 바뀝니다. AI 모델 Claude를 만드는 Anthropic의 프롬프트 안내도 「응답에 마크다운을 쓰지 마」 대신 「응답은 자연스럽게 이어지는 산문 문단으로 써」라고 쓰라고 권합니다(Claude 프롬프트 안내). 마크다운은 글에 제목 기호나 목록 기호를 붙여 형식을 꾸미는 표기법입니다.
같은 안내는 지시문의 형식이 응답의 형식에 영향을 줄 수 있다며, 지시문에서 마크다운을 빼면 응답의 마크다운도 줄어들 수 있다고 설명합니다. 또 「말줄임표를 절대 쓰지 마」라고만 쓰기보다 「응답은 음성 합성 프로그램이 소리 내어 읽으므로, 그 프로그램이 읽지 못하는 말줄임표는 쓰지 마」처럼 까닭을 함께 주면 모델이 그 설명에서 일반화할 수 있다고 적었습니다(Claude 프롬프트 안내).
예시로 「껄렁껄렁하게 쓰지 마」는 「단정하게 써」로, 「전문 용어를 쓰지 마」는 「중학생도 아는 낱말로 쓰고, 꼭 필요한 용어는 처음 나올 때 한 문장으로 풀어 써」로 바꿀 수 있습니다. 피하고 싶은 모습을 꼭 설명해야 한다면, 금지한 낱말만 적기보다 그와 반대되는 모습을 함께 적어야 모델이 따를 단서가 분명해집니다.
AI는 왜 「아니다」와 「다르다」라는 말을 특히 어려워하나요?
「아니다」는 문장의 뜻을 뒤집는 부정이라 낱말 하나를 놓치면 정반대로 읽히고, 「다르다」는 무엇과 다른지를 말해야 하는데, 그 기준이 되는 낱말이 다시 단서가 될 수 있기 때문입니다.
부정을 다루는 일은 모델이 커진다고 저절로 나아지지 않았습니다. 2022년 연구는 1억 2,500만~1,750억 개의 매개변수를 가진 OPT와 GPT-3 모델을 원래 지시와 그 지시를 부정으로 바꾼 지시로 각각 시험했는데, 부정한 지시에서는 모델이 클수록 성적이 오히려 떨어지는 역전 현상이 나타났다고 보고했습니다. 지시를 따르도록 더 학습시킨 InstructGPT를 포함해 시험한 모델들의 평균 성적은 원래 지시와 부정한 지시 모두에서 사람보다 크게 낮았습니다(Jang 외, 2022). 매개변수는 모델 안에서 학습으로 정해지는 숫자이고, 그 수가 클수록 대개 큰 모델입니다.
「다르다」를 직접 잰 연구는 찾지 못했지만, 앞의 연구들에서 본 것처럼 지시에 나온 낱말은 다음 글의 단서가 되기 쉽습니다. 예시로 「A사의 광고와 다른 문구를 써 줘」라고 하면, 새 문구에 A사 광고의 낱말과 분위기가 섞여 나올 수 있습니다. 다른 문구를 원할 때도 새 문구가 어떤 모습이어야 하는지를 적어 주어야, 모델이 기준으로 든 광고를 덜 따라 씁니다.
이미지 생성 도구의 네거티브 프롬프트 칸은 대화형 AI에게 주는 지시와 무엇이 다른가요?
이미지 생성 도구의 네거티브 프롬프트 칸은 문장으로 읽히는 지시가 아니라, 생성 과정에서 결과를 그 내용에서 멀어지게 하는 기준으로 따로 계산되는 입력입니다. 그래서 본 프롬프트에 「코끼리 없이」라고 쓰는 것과 네거티브 프롬프트 칸에 「코끼리」를 넣는 것은 다르게 작동합니다.
이미지 생성 모델 Stable Diffusion을 실행하는 공개 라이브러리 diffusers의 문서는 이 칸을 이미지에 넣지 않을 것을 이끄는 프롬프트로 설명하고, 안내 강도(guidance scale)를 1보다 크게 두어 이 안내 방식을 쓸 때만 효과가 있다고 적습니다(Hugging Face diffusers 문서). 이 안내 방식은 프롬프트를 넣고 계산한 결과와 넣지 않고 계산한 결과의 차이로 생성 방향을 정하는 「분류기 없는 안내」에 바탕을 둡니다(Ho·Salimans, 2022).
언어 모델과 대화하는 창에는 이런 별도의 칸이 없으므로, 대화형 AI에게 무언가를 피하게 하려면 앞의 방법처럼 할 것을 적는 편이 낫습니다.
AI가 지시를 따르지 않는 다른 까닭은 무엇인가요?
지시가 긴 입력의 가운데에 묻히면 모델이 그 지시를 덜 반영하는 것도 한 가지 까닭입니다. 이 현상은 "컨텍스트 윈도우란? AI가 긴 대화와 긴 문서에서 놓치는 것"에서 다룹니다.
모델이 읽을 정보를 고르는 일은 "컨텍스트 엔지니어링이란? 뜻과 프롬프트 엔지니어링과의 차이"에서 다룹니다. 다른 질문은 AX 가이드의 AI가 틀리는 이유에서 찾을 수 있습니다.
이 글의 근거와 한계
금지한 대상의 언급 비율은 Castricato 외(2024)를, 부정 표현을 다룬 연구는 Kassner·Schütze(2020)와 Jang 외(2022)를, 지시문을 쓰는 방법은 Anthropic의 Claude 프롬프트 안내를, 네거티브 프롬프트는 Hugging Face diffusers 문서와 Ho·Salimans(2022)를 따랐고, 모두 2026년 11월 4일에 원문을 확인했습니다. 각 연구는 주로 영어 문장과 그때의 모델로 잰 것이어서, 지금의 모델과 한국어 지시에서도 같은 크기로 나타난다고 볼 수는 없습니다. 「새는 날 수 [ ]」는 영어 원문의 예를 우리말로 옮긴 것이고, 문구와 지시문의 예는 설명을 위해 지어낸 예시입니다.