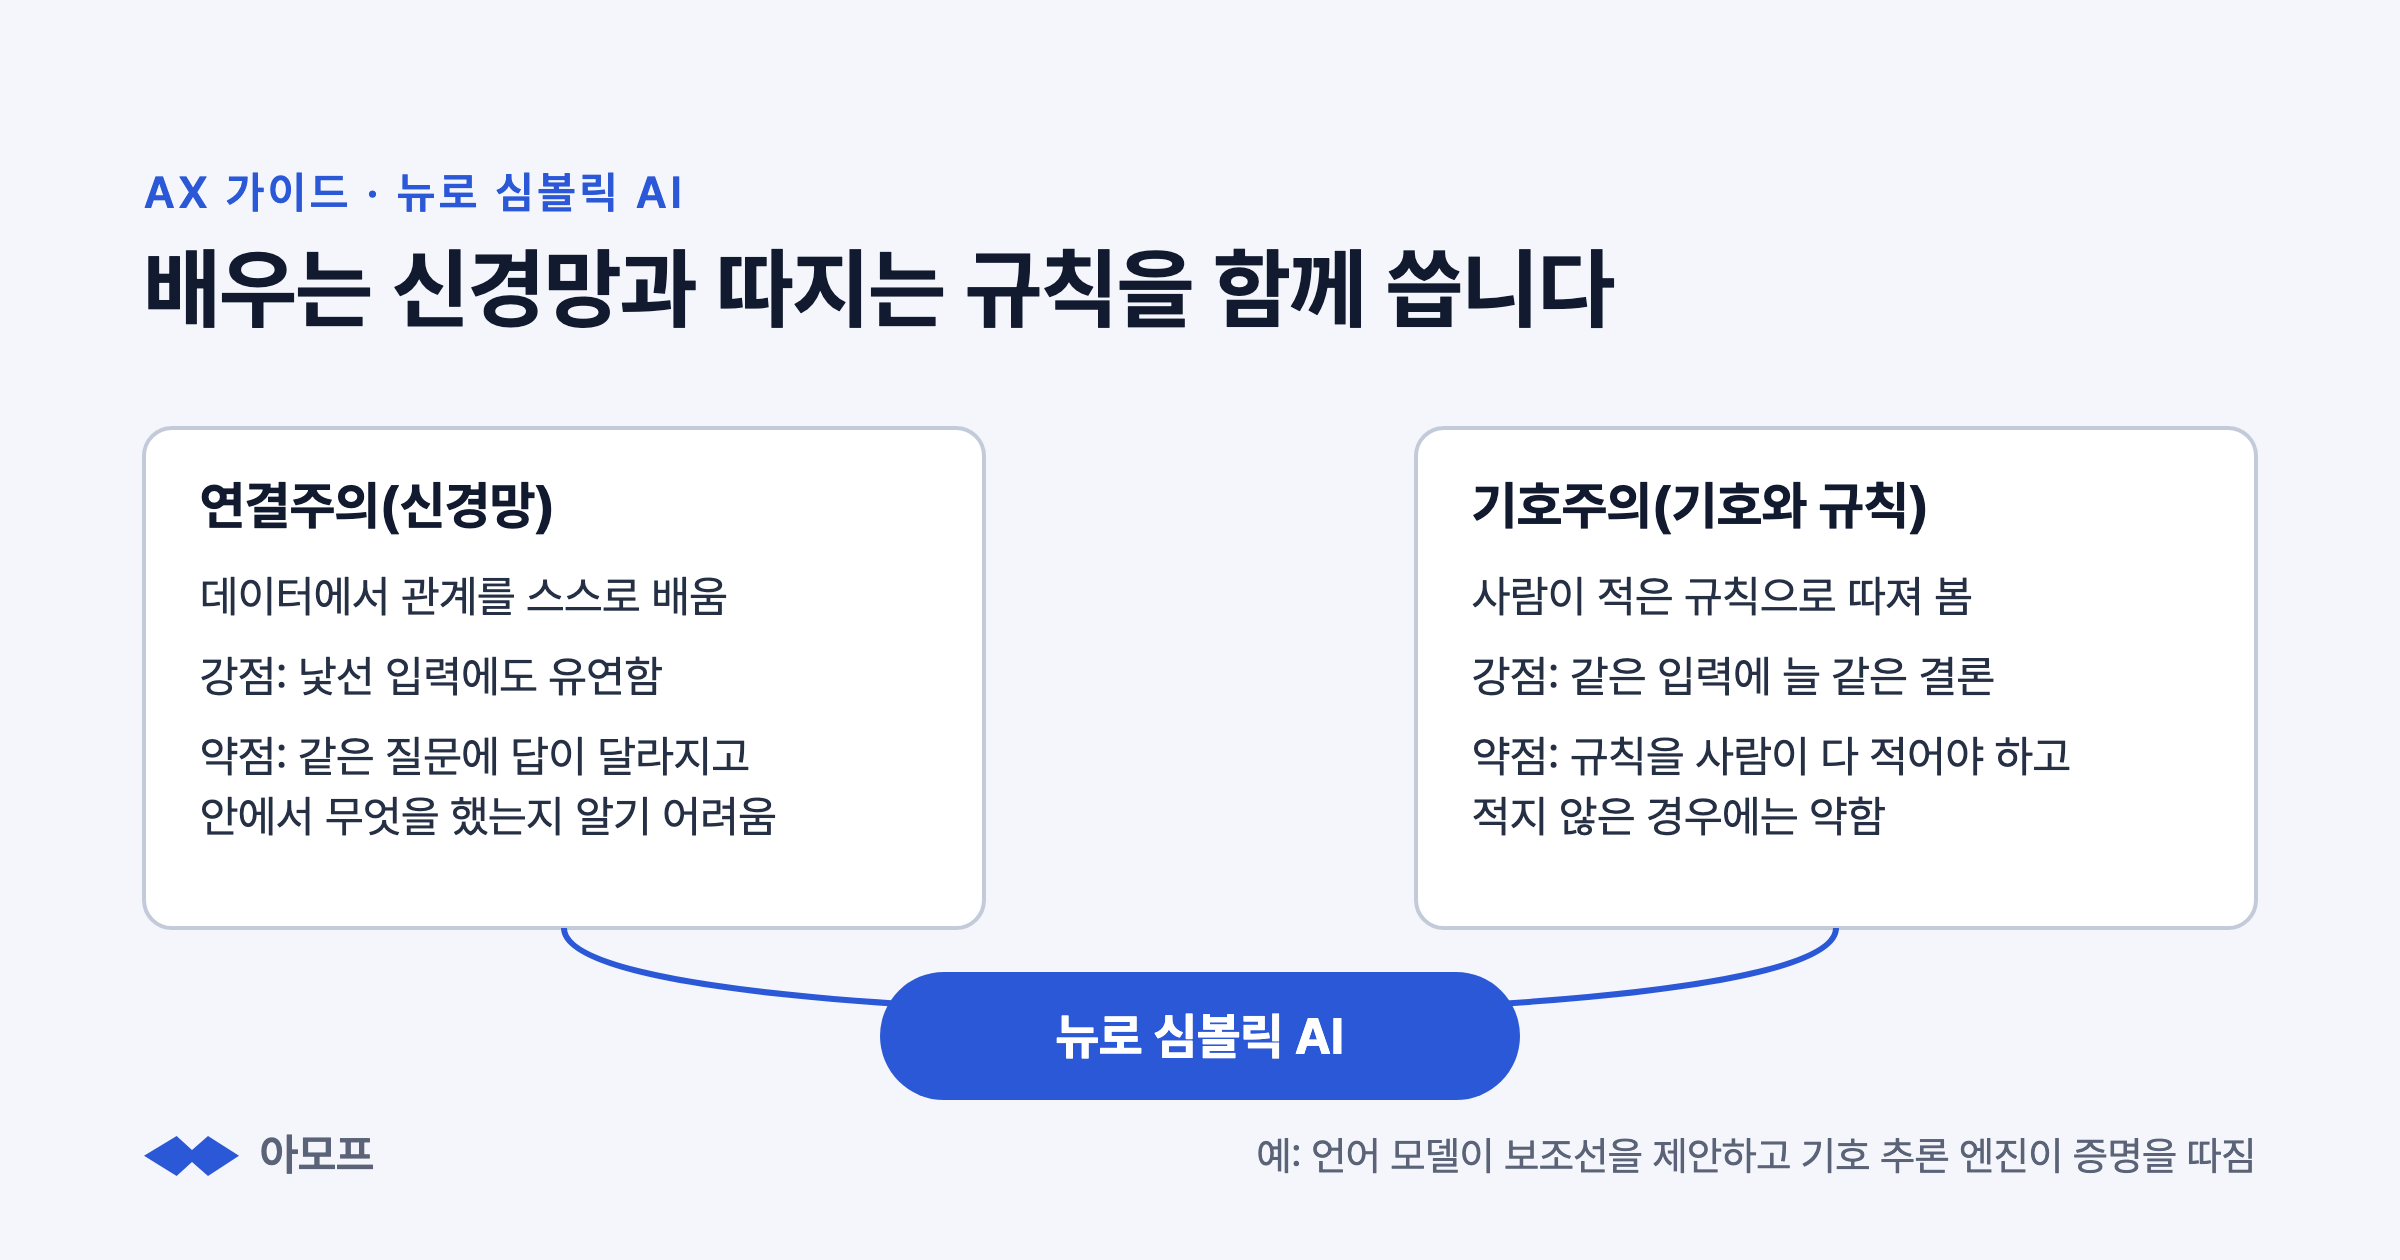
뉴로 심볼릭 AI(neuro-symbolic AI)는 데이터에서 패턴을 배우는 신경망과, 사람이 적어 둔 기호와 규칙으로 추론하는 기호 체계를 한 시스템 안에서 함께 쓰는 AI입니다. 신경망의 유연함에 규칙 기반 추론의 일관성과 설명 가능성을 더하려는 시도이며, AI 연구의 두 흐름인 연결주의와 기호주의를 잇습니다.
신경망은 사람의 신경 세포가 이어진 모양을 본떠, 많은 데이터에서 입력과 출력 사이의 관계를 스스로 익히는 계산 모형입니다. 이 분야를 개관한 논문은 뉴로 심볼릭 연구를 신경망의 탄탄한 학습 능력과 기호 표현의 추론 능력, 설명 가능성을 함께 갖추려는 연구로 설명합니다(Garcez·Lamb, 2020).
잘 알려진 예는 구글 딥마인드가 2024년 1월 17일 발표한 AlphaGeometry입니다. 신경망 언어 모델이 증명에 필요한 보조선 같은 새 작도를 제안하고 기호 추론 엔진이 그 작도를 써서 증명을 따지는 이 시스템은, 국제 수학 올림피아드 기하 문제 30개 가운데 25개를 정해진 시간 안에 풀었습니다. 같은 기하 문제 30개 가운데 이전 최고 방법은 10개를 풀었고, 금메달을 딴 사람들은 평균 25.9개를 풀었습니다(Google DeepMind, 2024).
기호주의 AI는 무엇인가요?
기호주의 AI는 사람이 세상의 개념과 관계를 기호와 규칙으로 직접 적어 넣고, 컴퓨터가 그 규칙을 따라 추론하게 하면 지능을 만들 수 있다고 보는 AI 연구의 흐름입니다. 앨런 뉴얼과 허버트 사이먼은 1975년 튜링상 수상 강연을 1976년 논문으로 내면서, 기호를 다루는 물리적 체계가 일반적인 지능 행동에 필요하고도 충분한 수단을 갖췄다는 가설을 내놓았습니다(Newell·Simon, 1976).
예시로 「한빛아파트 101동 1203호는 아파트다」, 「아파트는 주택의 한 종류다」, 「주택은 부동산의 한 종류다」라고 적어 두면, 컴퓨터는 적혀 있지 않던 「한빛아파트 101동 1203호는 부동산이다」를 끌어냅니다. W3C의 RDF 1.1 의미론은 이런 추론을 규칙으로 정해 두었는데, 어떤 것이 한 종류에 속하고 그 종류가 더 넓은 종류에 속하면 그것도 더 넓은 종류에 속한다는 규칙(rdfs9)과, 종류의 상하 관계가 이어진다는 규칙(rdfs11)입니다(W3C RDF 1.1 의미론, 2014).
전문가 시스템은 무엇이었나요?
전문가 시스템은 한 분야 전문가의 지식을 「이런 조건이면 이렇게 판단한다」 같은 규칙으로 옮겨 적고, 추론 엔진이 그 규칙을 적용해 전문가처럼 판단하게 한 기호주의 AI의 대표적인 응용입니다. 1970년대와 1980년대에 의학, 화학, 설비 구성 같은 분야에서 많이 만들어졌습니다.
스탠퍼드 대학 연구진이 만든 MYCIN은 감염병 환자에게 쓸 항생제를 고르는 전문가 시스템이었습니다. 1979년 학술지 JAMA에 실린 평가에서는 수막염 환자 10명의 사례를 두고, 이 분야 전문가 8명이 누가 처방했는지 모른 채 MYCIN의 처방과 사람 9명의 처방을 평가했습니다. 수막염 사례 10개를 두고 전문가 8명이 매긴 이 평가에서, 받아들일 만하다는 판정을 받은 비율은 MYCIN의 처방이 65%였고 교수진 전문의 5명의 처방은 42.5%에서 62.5% 사이였습니다(Yu 외, 1979).
그러나 규칙을 사람이 적고 고쳐야 했기 때문에, 성공한 전문가 시스템도 운영 비용이 커졌습니다. 컴퓨터 회사 DEC의 주문 구성 시스템 XCON 같은 초기의 성공 사례는 1990년대 초에 이르러 유지하기에 너무 비싸졌고, 전문가 시스템은 예상하지 못한 입력에 터무니없는 실수를 하는 「깨지기 쉬운」 시스템이라는 평가를 받았습니다(위키백과 「AI winter」).
연결주의 AI는 무엇인가요?
연결주의 AI는 사람이 규칙을 적어 넣지 않고, 서로 이어진 수많은 계산 단위로 이루어진 신경망이 데이터에서 관계를 스스로 익히게 하는 AI 연구의 흐름입니다. 지금의 언어 모델을 이루는 딥러닝과 트랜스포머 구조가 이 흐름에 속합니다.
여러 층으로 쌓은 신경망을 학습시키는 방법인 역전파를 널리 알린 논문은 1986년 학술지 Nature에 실렸고(Rumelhart 외, 1986), 지금의 언어 모델이 쓰는 트랜스포머 구조는 2017년에 발표되었습니다(Vaswani 외, 2017).
연결주의는 성능이 뛰어나지만, 신경망 안에서 무엇과 무엇을 어떻게 이었는지 사람이 들여다보기 어렵고, 확률로 다음 낱말을 고르므로 같은 질문에도 답이 달라질 수 있습니다. 같은 입력에 늘 같은 결론을 내는 기호주의의 추론과 정반대의 성질입니다.
Cyc 프로젝트는 왜 기대에 못 미쳤나요?
Cyc는 사람의 상식을 사람이 직접 적어 넣는 방식이 감당하기 어려울 만큼 많은 지식과 시간을 요구한다는 것을 보여 주었습니다. 1984년에 더글러스 레나트(Douglas Lenat)가 시작한 Cyc의 처음 계획은 상식 규칙 약 100만 개를 손으로 적어 두면 그다음부터는 컴퓨터가 글을 읽고 배우며 지식을 스스로 늘려 가는 것이었지만, 레나트와 인지 과학자 게리 마커스(Gary Marcus)가 2023년에 함께 쓴 논문에 따르면 40년 가까이 지난 뒤에도 Cyc의 지식은 대부분 사람이 손으로 적고 확인한 것이었습니다(Lenat, 1995; Lenat·Marcus, 2023).
레나트는 1995년 논문에서 그동안 약 100인년(한 사람이 100년 동안 일한 양)의 노력으로 일반 개념 약 10만 개와 상식 규칙 약 100만 개를 손으로 적어 넣었다고 밝히며, 이 지식을 바탕으로 1990년대 중반부터는 자연어 이해와 기계 학습으로 지식을 더 모으려 했다고 설명했습니다. 1984년에 시작할 때 성공할 가능성이 낮다는 것을 알았다고도 적었습니다(Lenat, 1995).
같은 2023년 논문에 따르면, 지금의 Cyc 지식 베이스는 논리학자와 프로그래머로 이루어진 팀이 40년 동안 약 2,000인년을 들여 만든 것이고, 사람이 직접 쓴 수천만 개의 주장으로 이루어져 있으며, 규칙 하나하나를 사람이 확인한 뒤에 넣습니다. 팀을 더 크게 늘렸을 때는 오히려 전체 생산성이 떨어졌다고도 적었습니다(Lenat·Marcus, 2023).
Cyc는 AI 침체기를 부른 원인이 아니라, 두 침체기 사이에 시작한 프로젝트입니다. AI 연구가 투자와 관심을 크게 잃은 침체기는 대략 1974~1980년과 1987~2000년의 두 번이었고, 첫 번째에는 1973년 영국의 라이트힐 보고서가 영국의 AI 연구를 크게 줄이는 계기가 되었습니다. 두 번째는 1987년 AI 전용 하드웨어 시장이 무너지고 전문가 시스템이 기대에 못 미치면서 왔습니다(위키백과 「AI winter」). Cyc가 시작한 1984년은 전문가 시스템이 한창 주목받던 때였습니다.
「쓰라린 교훈」은 무엇을 말하나요?
「쓰라린 교훈(The Bitter Lesson)」은 사람의 지식을 시스템에 넣는 방법보다, 계산 능력이 커질수록 함께 좋아지는 일반적인 방법이 결국 이긴다는 주장입니다. 강화 학습 연구자 리처드 서튼(Richard Sutton)이 2019년 3월 13일 쓴 짧은 글의 제목이며, 서튼은 이것을 70년 AI 연구에서 읽을 수 있는 가장 큰 교훈이라고 했습니다(Sutton, 2019).
서튼은 1997년 체스 세계 챔피언 카스파로프를 이긴 방법이 사람이 아는 체스의 구조가 아니라 대규모의 깊은 탐색이었고, 1970년대 미국 국방 연구 기관 DARPA가 연 음성 인식 경쟁에서도 낱말과 음소, 사람의 발성 기관에 관한 지식을 넣은 방법보다 은닉 마르코프 모형 같은 통계적 방법이 이겼다는 예를 듭니다. 그리고 계산이 커져도 계속 함께 좋아지는 방법은 탐색과 학습 두 가지라고 정리했습니다(Sutton, 2019).
서튼은 이 교훈이 쓰라린 까닭도 적었습니다. 연구자가 지식을 넣는 방법은 짧게 보면 늘 도움이 되고 만족스럽지만, 길게 보면 정체되거나 발전을 막고, 돌파는 결국 계산을 키우는 반대쪽 방법에서 왔다는 것입니다(Sutton, 2019). 다만 이 글은 서튼의 관점을 담은 에세이이고, 실험으로 증명한 결과는 아닙니다.
온톨로지 추론은 무엇인가요?
온톨로지 추론은 온톨로지에 적어 둔 개념의 관계와 규칙에서, 적혀 있지 않지만 논리적으로 따라 나오는 사실을 추론기라는 프로그램이 계산해 내는 일입니다. 기호주의의 추론을 오늘날의 표준 언어로 하는 방식이라고 볼 수 있습니다.
예시로 「가동률이 90% 이상인 생산 라인은 효율적인 라인이다」라는 규칙과 「라인 A는 생산 라인이고, 가동률은 93%다」라는 사실을 OWL로 적어 두면, 추론기는 「라인 A는 효율적인 라인이다」를 끌어냅니다. OWL은 W3C가 정한 온톨로지 언어이고, 추론기가 내놓을 결론은 OWL 2의 형식 의미론으로 미리 정해져 있습니다(W3C OWL 2 입문서, 2012). 이 추론이 데이터를 바꾸는 업무 시스템과 어떻게 다른지는 "팔란티어 온톨로지는 일반 온톨로지와 무엇이 다른가요?"에서 다룹니다.
왜 지금 기호주의와 연결주의를 합치려 하나요?
두 흐름의 약점이 서로의 강점과 맞물리기 때문입니다. 언어 모델은 사람이 규칙을 다 적지 않아도 글과 상황을 유연하게 다루지만 근거 없는 내용을 사실처럼 쓰거나 같은 질문에 다르게 답할 수 있고, 기호 체계는 규칙을 다 적기 어렵지만 같은 입력에 늘 같은 결론을 내고 그 결론에 이른 단계를 보여 줄 수 있습니다.
AlphaGeometry가 그 예입니다. 딥마인드는 착상을 빠르게 내는 언어 모델과 차근차근 따지는 기호 추론 엔진의 결합을, 빠른 생각과 느린 생각으로 사람의 사고를 나눈 「생각에 관한 생각(Thinking, Fast and Slow)」의 구분에 견주어 설명했습니다. 이 시스템은 사람이 풀어 보인 풀이 없이, 직접 만든 1억 개의 합성 학습 예제로 학습했습니다(Google DeepMind, 2024).
Cyc를 만든 레나트도 2023년 논문에서, 믿을 수 있는 범용 AI라면 언어 모델의 방식과 더 형식적인 방식을 섞어야 한다고 주장했습니다(Lenat·Marcus, 2023). 언어 모델이 근거 없는 내용을 쓰는 까닭은 "할루시네이션이란? AI 환각의 뜻과 원인, 문서 업무에서 나타나는 모양"에서 다룹니다.
온톨로지와 지식 그래프부터 보려면 무엇을 읽으면 되나요?
기호주의의 지식을 담는 틀인 온톨로지는 "온톨로지란? 뜻과 구성 요소, 데이터베이스와의 차이"에서, 사실을 점과 선으로 담는 지식 그래프는 "지식 그래프란? 뜻과 시소러스·택소노미와의 차이"에서 다룹니다. 다른 질문은 AX 가이드의 지식 구조에서 찾을 수 있습니다.
이 글의 근거와 한계
뉴로 심볼릭 AI의 정의는 Garcez·Lamb(2020)를, AlphaGeometry는 2024년 구글 딥마인드 발표를, 기호주의의 가설은 Newell·Simon(1976)을, 추론 규칙은 W3C의 RDF 1.1 의미론과 OWL 2 입문서를, MYCIN은 Yu 외(1979)를, Cyc는 레나트의 1995년 논문과 2023년 논문을, 쓰라린 교훈은 서튼의 2019년 글을 따랐고, 모두 2026년 11월 4일에 원문을 확인했습니다. 침체기의 연대와 XCON의 유지 비용은 위키백과의 「AI winter」 항목을 따랐으며, 침체기의 범위는 자료마다 조금씩 다르게 잡습니다. 아파트와 생산 라인의 예는 설명을 위해 지어낸 예시입니다.