할루시네이션(AI 환각)은 AI가 쓴 답이 실제 사실이나 사용자가 건넨 지시와 자료에 맞지 않는 현상입니다. OpenAI가 2025년 9월에 공개한 논문은, 맞힌 문항 수만 세는 평가에서는 모를 때 추측하는 모델이 점수를 더 받기 때문에 이 현상이 쉽게 줄지 않는다고 분석했습니다(Kalai 외, 2025).
모를 때 답하지 않게 하면 틀린 답을 줄일 수 있지만(Kalai 외, 2025), 틀린 답이 모두 사라지지는 않으므로 틀렸을 때 사람이 알아챌 수 있게 하는 장치도 함께 필요합니다. 이 글은 원인과 종류에 이어, 출처를 붙인 답과 긴 대화, 그리고 규격서나 논문처럼 조건과 수치를 적은 기술 문서에서 이 현상이 나타나는 모양과 확인할 것을 정리합니다.
할루시네이션은 왜 생기나요?
할루시네이션은 AI가 많은 글을 읽으며 다음 낱말을 예측하도록 먼저 학습하는 단계(사전 학습)에서 규칙 없이 드물게 나오는 사실을 정확히 익히지 못하고, 그 뒤에는 맞힌 수만 세는 평가에서 점수를 잘 받도록 다듬어지면서 모를 때 추측하는 경향이 남기 때문에 생깁니다(Kalai 외, 2025). 앞에서 소개한 OpenAI 논문이 든 두 원인입니다.
언어 모델은 글을 읽고 쓰도록 학습한 AI 모델로, ChatGPT 같은 서비스의 바탕입니다. 사전 학습은 글에서 다음 낱말이 나올 확률을 학습 자료에 맞추는 것을 목표로 하는데, 논문은 학습 자료에 오류가 하나도 없어도 이 목표 때문에 틀린 답이 생긴다고 설명합니다. 맞춤법처럼 규칙이 일정한 것은 모델이 정확하게 익히지만, 어떤 사람의 생일처럼 규칙이 없는 사실은 글의 모양만으로 짐작할 수 없기 때문입니다(Kalai 외, 2025).
논문이 든 예에 따르면, 학습 자료에 딱 한 번만 나오는 생일 사실이 전체의 20%일 때 사전 학습만 마친 모델은 생일 사실의 적어도 20%에서 할루시네이션을 일으킬 것으로 예상됩니다(Kalai 외, 2025). 기술 문서에 한 번만 적힌 제품별 시험값도 규칙으로 짐작할 수 없는 사실이므로, 모델이 기억에 기대어 답하면 같은 문제가 생길 수 있습니다.
두 번째 원인은 평가의 채점 방식입니다. 평가는 여러 모델에게 같은 문제를 풀게 해 점수로 견주는 시험인데, 논문이 살펴본 널리 쓰이는 평가는 대부분 맞으면 1점을 주고 틀리거나 "모르겠다"고 하면 똑같이 0점을 줍니다. 이런 채점에서는 모르겠다고 답하는 쪽이 언제나 손해이므로, 모델은 객관식 시험에서 모르는 문제를 찍는 학생처럼 추측하게 됩니다(Kalai 외, 2025).
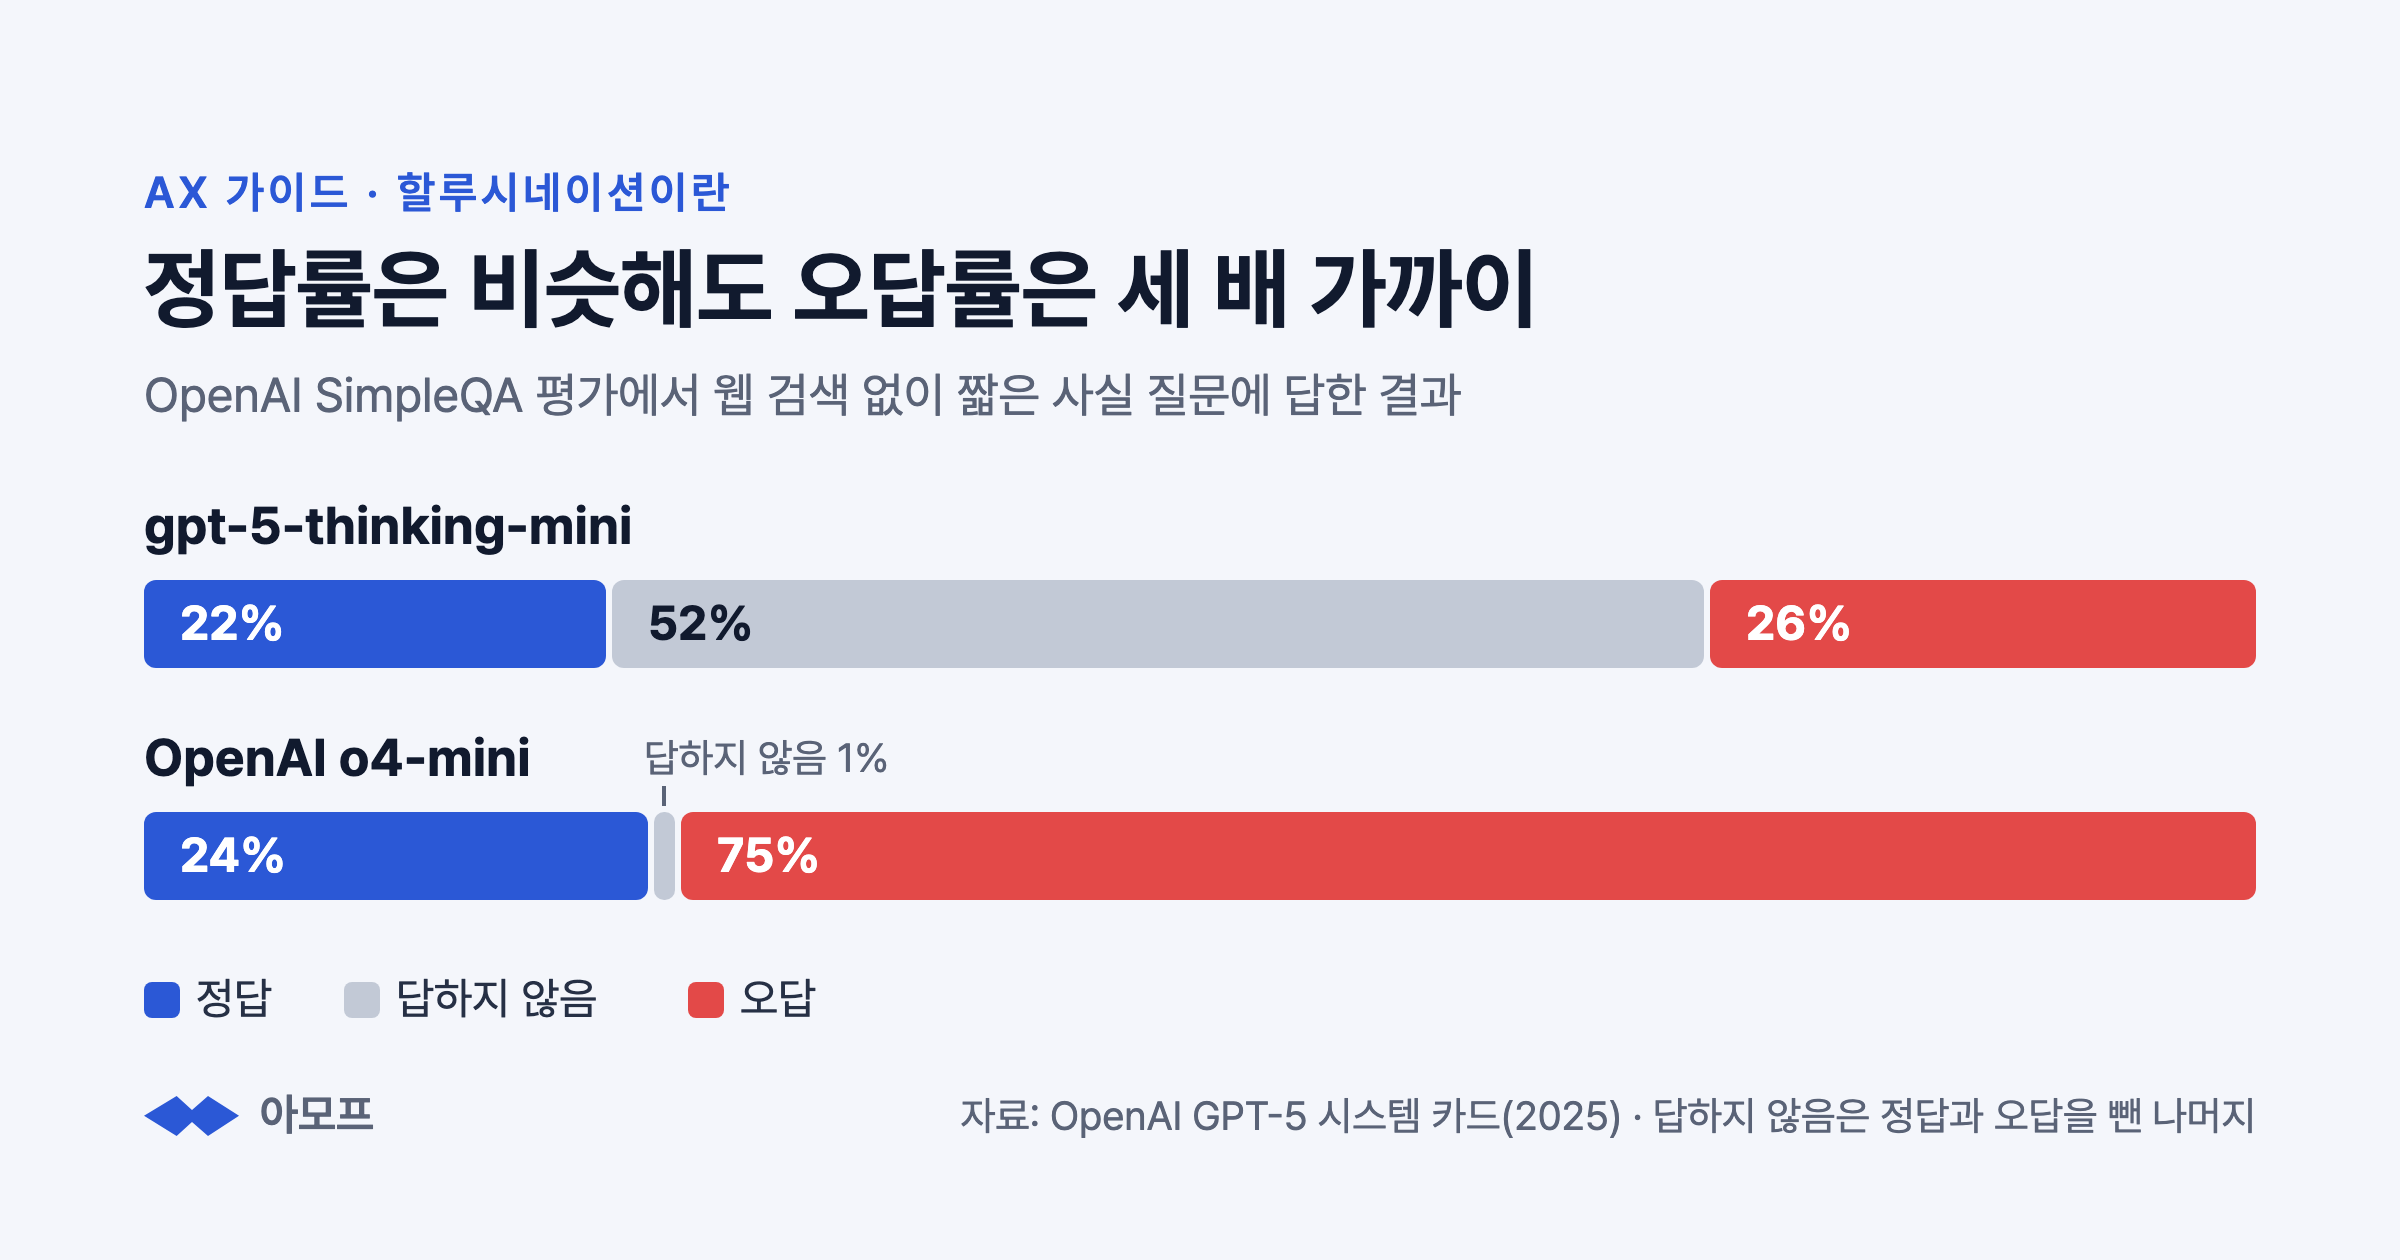
OpenAI의 GPT-5 시스템 카드(2025년 8월)에 실린 SimpleQA 결과에서, 웹 검색 없이 답한 gpt-5-thinking-mini는 정답 22%, 오답 26%였고 OpenAI o4-mini는 정답 24%, 오답 75%였습니다(OpenAI, 2025). SimpleQA는 답을 정답, 오답, 답하지 않음의 셋으로 채점하므로(Wei 외, 2024), 나머지인 52%와 1%가 답하지 않은 비율입니다. 정답률만 보면 o4-mini가 2%포인트 앞서지만, 틀린 답은 세 배 가까이 많았습니다.
그래서 논문은 할루시네이션만 재는 평가를 늘리기보다, 널리 쓰는 평가의 채점을 바꿔 틀린 답에 감점을 주고 그 기준을 지시문에 밝히자고 제안합니다. 예를 들어 "90%보다 더 확신할 때만 답하라. 맞으면 1점, 틀리면 9점 감점, 모르겠다고 하면 0점이다"라고 밝혀 두면, 확신이 낮을 때 답하지 않는 모델이 손해를 보지 않습니다(Kalai 외, 2025).
할루시네이션에는 어떤 종류가 있나요?
할루시네이션은 답이 실제 세계의 사실과 어긋나는 사실성(factuality) 할루시네이션과, 사용자가 준 지시나 자료와 어긋나거나 답 안에서 앞뒤가 맞지 않는 충실성(faithfulness) 할루시네이션의 두 가지로 나뉩니다(Huang 외, 2023). 대형 언어 모델(LLM)의 할루시네이션을 다룬 여러 연구를 모아 정리한 개관 논문이 쓰는 분류입니다.
충실성 할루시네이션은 지시한 일과 다른 일을 하는 경우, 건넨 문서나 글과 다른 내용을 쓰는 경우, 답 안에서 앞뒤 논리가 맞지 않는 경우의 세 가지로 다시 나뉩니다(Huang 외, 2023). 문서를 건네고 묻는 업무에서는 둘째 경우가 가장 직접적인 문제이며, 건넨 문서에 없는 값이 섞이면 문서를 근거로 답하게 한 목적이 사라집니다.
할루시네이션이라는 말은 어디에서 왔나요?
할루시네이션이라는 말은 영상을 다루는 컴퓨터 비전 분야에서 먼저 쓰였고, 처음에는 오류가 아니라 2000년 Baker와 Kanade의 연구처럼 해상도가 낮은 얼굴 영상을 고해상도로 바꾸는 기술을 가리켰습니다. 글을 만드는 AI에서는 원문과 맞지 않거나 뜻이 통하지 않는 글을 만드는 오류를 가리키게 되었습니다(Ji 외, 2022).
출처를 붙인 AI 답에도 할루시네이션이 생기나요?
생깁니다. 스탠퍼드 대학 연구진이 2023년에 출처 링크를 붙여 답하는 AI 검색 서비스 네 곳의 답을 사람이 평가했더니, 네 곳을 평균해 답 문장의 51.5%만 붙은 인용으로 완전히 뒷받침되었고 인용의 74.5%만 그 인용이 붙은 문장을 뒷받침했습니다(Liu·Zhang·Liang, 2023).
이런 서비스를 생성형 검색 엔진이라고 부르며, 웹을 검색해 읽은 내용으로 답을 쓰고 답 안에 출처 링크(인용)를 함께 붙여 줍니다. 연구진은 2023년 2월 말부터 3월 말까지 Bing Chat, NeevaAI, perplexity.ai, YouChat에 각각 질문 1,450개를 묻고, 답의 문장 하나하나가 붙은 인용으로 뒷받침되는지와 붙은 인용 하나하나가 그 문장을 뒷받침하는지를 평가자가 판정하게 했습니다(Liu·Zhang·Liang, 2023).
이 연구에서는 답이 도움이 되어 보인다는 점수가 높은 서비스일수록 인용이 부정확했습니다. 평가자가 1점부터 5점까지로 매긴 이 점수의 평균은 붙은 인용이 문장을 뒷받침한 비율이 가장 높았던 Bing Chat(89.5%)에서 가장 낮았고(4.34점), 그 비율이 가장 낮았던 YouChat(63.6%)에서 가장 높았습니다(4.62점). 연구진이 네 서비스의 평균값으로 잰, 인용이 문장을 뒷받침한 비율과 도움이 되어 보인다는 점수 사이의 상관계수(두 값이 함께 움직이는 정도를 −1부터 1까지로 나타낸 값)는 −0.96이었습니다. 다만 견준 서비스가 네 곳뿐이라 일반적인 법칙으로 보기는 어렵습니다. 연구진은 출처의 문장을 거의 그대로 옮긴 답은 인용이 맞지만 질문과 덜 맞고, 출처에서 벗어난 답은 질문에 맞고 도움이 되어 보이지만 인용이 틀리기 쉽다고 해석했습니다(Liu·Zhang·Liang, 2023).
이 결과는 출처 링크가 붙어 있다는 것만으로 답이 맞는지 알 수 없다는 뜻입니다. 질문과 관련된 자료를 찾아 AI에게 함께 읽히는 RAG(검색 증강 생성)도 마찬가지이며, RAG가 어느 단계에서 틀리는지는 "RAG란? 검색 증강 생성의 뜻과 작동 순서, 한계"에 정리했습니다.
대화가 길어지면 할루시네이션이 늘어나나요?
늘어날 수 있습니다. 언어 모델은 낱말을 하나 쓸 때마다 앞의 대화와 자기가 방금 쓴 글까지 다시 읽고 다음 낱말을 고르므로, 한 번의 답 안에서도 첫머리에서 틀리게 정한 내용을 뒤의 설명이 이어받기 쉽습니다(Zhang 외, 2023).
워싱턴 대학 등의 연구진은 2023년 실험에서, GPT-4가 답의 첫머리에서 9677이 소수(1과 자기 자신으로만 나누어떨어지는 수)가 아니라고 단정한 뒤 13 × 745 = 9677이라는 틀린 근거를 이어 쓰는 것을 보였습니다. 이 실험에서 답의 첫 낱말이 "예"나 "아니요"인 경우는 GPT-4에서 95.67%, ChatGPT에서 98.40%였습니다. 그런데 따로 물었을 때 GPT-4는 13이 9677의 약수가 아니라는 것을 아는 것으로 보였습니다. 소수 판별, 미국 상원의원 찾기, 항공편 연결의 세 가지 질문 묶음으로 2023년에 시험한 ChatGPT와 GPT-4는 자기 답에 들어간 틀린 주장 가운데 각각 67%와 87%를 따로 물었을 때 틀렸다고 알아보았습니다(Zhang 외, 2023). 연구진은 앞의 실수에 맞추려다 실수가 더 늘어나는 이 현상을 hallucination snowballing(눈덩이처럼 불어나는 할루시네이션)이라고 불렀습니다.
여러 차례 주고받는 대화에서도 비슷한 일이 생깁니다. Microsoft Research와 Salesforce Research의 연구진이 2025년에 언어 모델 15개로 대화 20만 건 이상을 모의 실험했더니, 지시를 한 번에 다 주지 않고 여러 차례에 나눠 주었을 때 코드 작성, 수학, 요약 같은 여섯 가지 작업의 성능이 평균 39% 떨어졌고, 이 하락은 두 차례만 주고받는 대화에서도 나타났습니다(Laban 외, 2025). 이 연구는 할루시네이션만이 아니라 작업 성능 전체를 쟀지만, 모델이 앞쪽 차례에서 섣불리 가정해 답을 내놓은 뒤 그 답에 지나치게 기댄다는 설명은 앞의 실험과 같은 방향입니다.
대화가 아주 길어질 때 앞의 내용을 놓치는 문제는 AI가 한 번에 읽고 쓸 수 있는 글의 범위인 컨텍스트 윈도우와 관련이 있으며, "컨텍스트 윈도우란? AI가 긴 대화와 긴 문서에서 놓치는 것"에서 따로 다룹니다.
기술 문서 업무에서 할루시네이션은 어떤 모양으로 나타나나요?
기술 문서 업무에서 눈여겨볼 할루시네이션은 수치와 출처의 오류입니다. 원문에 있는 값에 틀린 위치를 근거로 붙이는 일과 없는 참고 문헌을 지어내는 일은 아래처럼 실제로 확인된 예가 있고, 시험 조건이 다른 값을 옮겨 쓰는 일도 생길 수 있습니다.
아모프 창업팀이 2026년 9월 22일에 시제품을 시험할 때, AI가 논문의 13번째 줄에만 있는 수치를 설명에 쓰면서 근거로는 14번째 줄만 인용한 일이 있었습니다. 수치는 논문에 실제로 있는 값이었지만, 붙은 근거만으로는 그 수치를 되짚을 수 없었습니다. 내용이 맞아도 출처가 틀리면 사람이 그 내용을 원문에서 확인할 수 없다는 점에서, 앞의 생성형 검색 엔진 연구가 잰 잘못 붙은 인용과 같은 종류의 오류입니다.
미국의 두 연구자가 2023년에 발표한 연구에서 ChatGPT의 GPT-3.5와 GPT-4에게 42개 주제로 짧은 문헌 검토 글(한 주제의 기존 연구를 모아 정리한 글) 84편을 쓰게 하고 참고 문헌 636개를 확인했더니, 존재하지 않는 문헌이 GPT-3.5에서 55%, GPT-4에서 18%였습니다. 실제로 있는 문헌 가운데서도 GPT-3.5의 43%, GPT-4의 24%에 중대한 인용 오류가 있었습니다(Walters·Wilder, 2023).
시험 조건이 다른 값을 옮겨 쓰는 오류는 인용만 확인해서는 드러나지 않습니다. 예시로, 시험 성적서에 "23 °C에서 측정한 인장 강도 45 MPa"라고 적혀 있다고 해 봅시다. 인장 강도는 재료를 잡아당길 때 끊어지기 전까지 견디는 단면적당 힘이고, MPa(메가파스칼)는 그 단위입니다. AI가 이 값을 80 °C의 인장 강도를 묻는 질문의 답으로 쓰면, 숫자는 원문에 글자 그대로 있어도 답은 틀립니다. 논문 PDF의 표를 AI가 읽을 때 생기는 문제는 "AI는 논문 PDF의 표에서 수치를 제대로 읽을 수 있나요?"에 따로 정리했습니다.
할루시네이션을 줄이려면 무엇을 확인하나요?
AI의 답에서 할루시네이션을 줄이고 가려내려면 인용한 문장이 원문에 글자 그대로 있는지, 수치의 단위와 시험 조건이 질문과 같은지, 모를 때 답하지 않아도 되도록 지시했는지를 확인합니다.
첫째, 인용은 원문을 열어 그 문장을 직접 찾아봅니다. 2023년 생성형 검색 엔진 연구에서 네 곳을 평균해 인용의 4분의 1가량이 붙은 문장을 뒷받침하지 못했기 때문입니다(Liu·Zhang·Liang, 2023).
둘째, 수치는 숫자만 맞춰 보지 말고 단위와 시험 조건을 함께 봅니다. 앞의 인장 강도 예시처럼 숫자가 원문에 그대로 있어도 조건이 다르면 다른 값입니다.
셋째, 모를 때 답하지 않아도 되도록 했는지 봅니다. 답하지 않는 것과 틀린 답을 똑같이 0점으로 다루면 추측이 유리해진다는 것이 앞의 분석이므로(Kalai 외, 2025), 예시로 "근거를 찾지 못하면 찾지 못했다고 답하라"처럼, 모를 때는 답하지 않아도 된다고 지시문에 적어 둡니다. 같은 이유로 AI 도구를 견줄 때 맞힌 수만 세면, 추측을 많이 하는 도구가 더 정확해 보일 수 있습니다.
다만 모를 때 답하지 않게 해도 틀린 답이 모두 사라지지는 않습니다. OpenAI의 SimpleQA 결과에서 질문의 절반 넘게 답하지 않은 gpt-5-thinking-mini도 전체 질문의 26%에서 틀린 답을 냈으므로(OpenAI, 2025), 답에 붙은 근거를 사람이 원문에서 되짚을 수 있어야 틀린 답을 알아챌 수 있습니다.
이 글의 근거와 한계
원인과 채점은 Kalai 외(2025)와 OpenAI(2025)를, 종류와 말의 유래는 Huang 외(2023)와 Ji 외(2022)를 따랐습니다. 글에 나온 수치는 각 연구가 밝힌 시기의 모델과 서비스로 잰 값이어서, 지금의 AI에서도 같은 값이 나온다고 볼 수는 없습니다. 2026년 9월 22일의 사례는 아모프 창업팀이 시제품을 시험하며 겪은 한 건으로 실제 회사의 업무에 쓴 결과가 아니며, "예시"라고 적은 수치와 지시문은 설명을 위해 지어낸 것입니다.