하네스 엔지니어링(harness engineering)은 AI 에이전트에서 언어 모델을 뺀 나머지 부분, 즉 모델에게 지시와 도구를 건네고 모델이 고른 동작을 실제로 실행하는 프로그램을 설계하는 일입니다. 하네스라는 말은 AI 제품 안에서 모델을 감싸는 프로그램을 가리킬 때도 있고, AI에게 개발을 맡긴 팀이 꾸린 작업 환경을 가리킬 때도 있습니다.
여기서 언어 모델은 글을 읽고 이어질 글을 만들어 내는 AI 모델이고, AI 에이전트는 언어 모델에 도구와 규칙을 묶어, 사람의 요청이나 정해 둔 시각·사건에 따라 여러 단계의 일을 이어 처리하는 프로그램이며, 코딩 에이전트는 코드를 쓰는 AI 에이전트입니다.
같은 모델이라도 하네스에 따라 결과가 크게 달라집니다. 에이전트 개발 도구를 만드는 LangChain은 2026년 2월 17일, 모델(gpt-5.2-codex)은 그대로 두고 하네스만 고쳐서 자사 코딩 에이전트의 Terminal Bench 2.0(89개 과제로 이루어진 코딩 평가) 점수를 52.8%에서 66.5%로 올렸다고 밝혔습니다(LangChain, 2026년 2월).
하네스 엔지니어링에서 하네스는 무엇을 가리키나요?
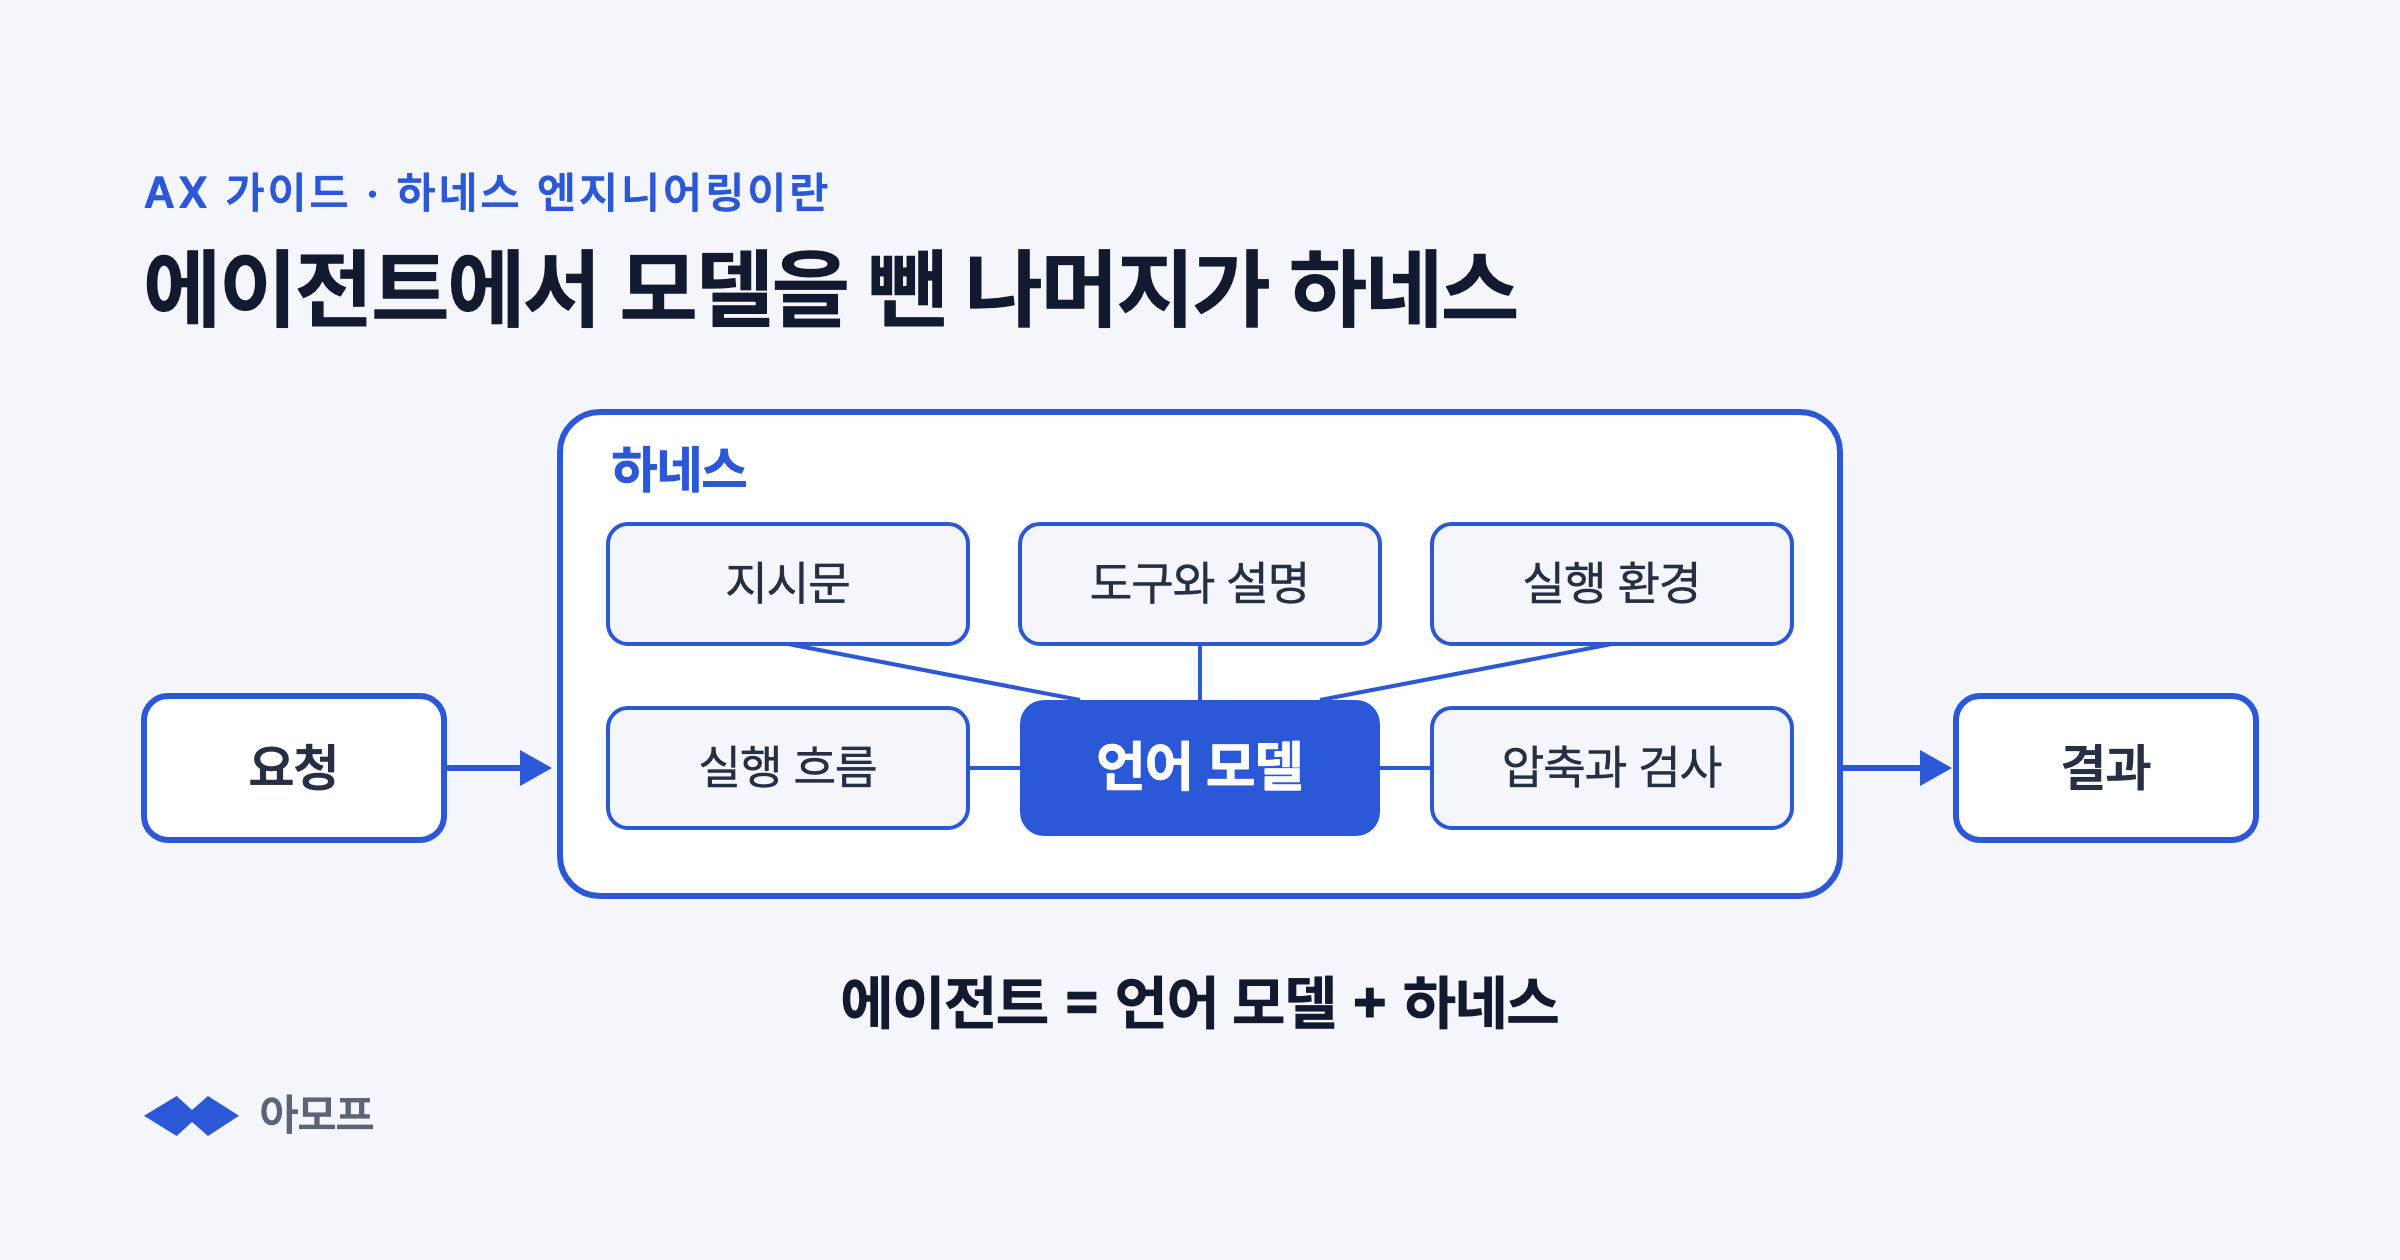
하네스(AI 하네스)는 언어 모델을 감싸서 모델에게 지시문과 도구를 건네고, 모델이 고른 동작을 실제로 실행해 그 결과를 다시 모델에게 돌려주는 프로그램과 설정을 가리킵니다. 그 프로그램이 AI 제품 안에 있는지, AI로 개발하는 작업 환경에 있는지에 따라 가리키는 범위가 달라집니다.
첫째는 AI 제품 안에서 모델을 감싸는 하네스입니다. LangChain의 트리베디(Vivek Trivedy)는 하네스를 모델이 아닌 모든 코드와 설정, 실행 논리로 정의하고, 시스템 프롬프트, 도구와 스킬 그리고 그 설명, 샌드박스 같은 실행 환경, 일을 나누고 넘기는 실행 흐름, 대화 압축이나 코드 검사처럼 정해진 때에 자동으로 실행되는 처리를 예로 듭니다(LangChain, 2026년 3월). 시스템 프롬프트는 모델에게 매번 먼저 건네는 기본 지시문이고, 도구는 파일 읽기처럼 모델이 불러 쓰는 기능이며, 스킬은 특정 작업에 쓸 지시와 파일을 묶어 둔 것이고, 샌드박스는 프로그램을 바깥과 격리해 실행하는 공간입니다.
트리베디가 하네스의 예로 든 압축(compaction)은 대화가 길어질 때 앞부분을 요약해 줄이는 기능입니다(LangChain, 2026년 3월). 모델이 답을 만들 때 함께 읽는 글을 컨텍스트라고 하고, 모델이 쓰는 답까지 합쳐 한 번에 다룰 수 있는 글의 한도를 컨텍스트 윈도우라고 합니다(Claude 컨텍스트 윈도우 문서). AI 모델 Claude를 만드는 Anthropic의 코딩 도구 Claude Code는 한도에 가까워진 대화 기록을 모델에게 넘겨 요약하게 하고, 그 요약과 최근에 연 파일 다섯 개로 일을 이어 갑니다(Anthropic, 2025년 9월). 한도가 찰 때 생기는 일은 컨텍스트 윈도우란 글에서 따로 다룹니다.
둘째는 AI에게 개발을 맡긴 팀이 꾸리는 작업 환경입니다. ChatGPT를 만드는 OpenAI가 2026년 2월 11일 공개한 글에 따르면, 엔지니어 세 명으로 시작한 팀이 5개월 동안 사람이 코드를 한 줄도 직접 쓰지 않고 코딩 에이전트 Codex만으로 내부 베타 제품을 만들었고, 그동안 저장소(코드와 문서를 보관하는 곳)에는 애플리케이션 코드와 인프라, 도구, 문서를 합쳐 약 100만 줄이 쌓였습니다. 이 팀은 엔지니어의 주된 일이 코드를 쓰는 일에서 환경을 설계하고 의도를 명시하며 피드백 루프(결과를 다시 받아 다음 작업을 고치게 하는 구조)를 만드는 일로 바뀌면 무엇이 달라지는지 알아야 했다고 적었습니다. 그리고 실제로 팀의 주된 일은 에이전트가 쓸모 있는 일을 하도록 돕는 것이 되었다고 밝혔습니다(OpenAI, 2026).
기술 컨설팅 회사 Thoughtworks의 엔지니어 뵈켈러(Birgitta Böckeler)는 코딩 에이전트의 하네스 가운데 시스템 프롬프트 같은 일부는 이미 도구에 들어 있고, 사용자는 그 바깥에 자기 업무에 맞춘 바깥 하네스(outer harness)를 만든다고 나눠 설명합니다(Böckeler, 2026). 우아한형제들 기술 블로그도 AI 코딩 도구에 프로젝트 규칙을 매번 다시 설명해야 했던 문제를, 팀 전용 규칙과 스킬로 만든 하네스로 다룬 사례를 소개했습니다(이재홍, 2026).
하네스 엔지니어링은 프롬프트·컨텍스트·루프 엔지니어링과 무엇이 다른가요?
하네스 엔지니어링은 지시문이나 입력 한 번이 아니라 모델을 둘러싼 실행 환경 전체를 설계한다는 점에서 다릅니다. 프롬프트 엔지니어링은 모델에게 주는 지시문을, 컨텍스트 엔지니어링은 모델이 한 번에 읽는 정보 전체를, 루프 엔지니어링은 목표에 닿을 때까지 에이전트를 되풀이해 실행하는 구조를 설계합니다.
네 가지의 경계는 서로 겹칩니다. Anthropic은 컨텍스트 엔지니어링을 모델이 답을 만드는 동안 읽는 토큰(모델이 글을 잘게 나눠 읽고 쓰는 단위)의 가장 알맞은 묶음을 고르고 관리하는 전략으로 정의하고, 프롬프트 엔지니어링이 자연스럽게 발전한 단계로 봅니다(Anthropic, 2025년 9월). 뵈켈러는 코딩 에이전트의 사용자가 하네스를 만드는 일을 컨텍스트 엔지니어링의 한 형태로 봅니다(Böckeler, 2026). 그래서 네 이름은 서로를 대신하는 기술이라기보다, 같은 시스템을 어디까지 넓게 보고 설계하느냐에 따라 붙는 이름에 가깝습니다.
정리하면 네 가지는 설계 대상과 다루는 단위가 다르고, 대표적인 실패도 각자 다루는 단위에서 생깁니다.
| 구분 | 설계 대상 | 다루는 단위 | 대표적인 실패 |
|---|---|---|---|
| 프롬프트 엔지니어링 | 모델에게 주는 지시문(OpenAI 프롬프트 문서) | 요청 한 번, 즉 모델 호출 한 번(IBM, 2026) | 같은 계열의 모델이라도 버전이 바뀌면 같은 지시문이 다른 결과를 낼 수 있음(OpenAI 프롬프트 문서) |
| 컨텍스트 엔지니어링 | 지시문, 도구 설명, 대화 기록을 포함해 모델이 읽는 정보 전체(Anthropic, 2025년 9월) | 모델이 답을 만들 때 함께 읽는 토큰 묶음(Anthropic, 2025년 9월) | 토큰이 늘수록 그 안의 정보를 정확히 떠올리는 능력이 떨어짐(Anthropic, 2025년 9월) |
| 하네스 엔지니어링 | 도구, 지침 문서, 코드를 검사하는 장치 같은 모델 바깥의 실행 환경(OpenAI, 2026) | 에이전트에서 모델을 뺀 나머지 전체(Böckeler, 2026) | 지침을 파일 하나에 몰아넣으면 에이전트가 주요 제약을 놓침(OpenAI, 2026) |
| 루프 엔지니어링 | 목표를 이룰 때까지 되풀이하는 구조와 종료 조건(IBM, 2026) | 목표, 행동, 관찰, 조정으로 이루어진 반복 한 바퀴(IBM, 2026) | 반복되는 실패와 불필요한 작업으로 토큰을 낭비함(IBM, 2026) |
AI 에이전트와 하네스는 같은 말인가요?
같은 말이 아닙니다. AI 에이전트는 언어 모델과 하네스를 합친 전체이고, 하네스는 그 가운데 모델을 뺀 나머지 부분입니다.
트리베디는 "에이전트 = 모델 + 하네스"라는 식과 "모델이 아니면 하네스"라는 말로 이 관계를 정리했고, 뵈켈러는 이 식을 인용하며 하네스가 AI 에이전트에서 모델 자체를 뺀 모든 것을 한마디로 부르는 말로 자리 잡았다고 적었습니다(LangChain, 2026년 3월; Böckeler, 2026). Anthropic은 에이전트가 대개 환경에서 돌아온 결과를 보며 도구를 되풀이해 쓰는 언어 모델이라고 설명하고(Anthropic, 2024년 12월), 에이전트를 만드는 개발 도구 묶음인 Claude Agent SDK를 범용 에이전트 하네스라고 부릅니다(Anthropic, 2025년 11월). 하네스에 모델을 연결하면 곧바로 에이전트로 움직이므로, 같은 제품이 하네스로도 에이전트로도 불립니다.
예시로 쇼핑몰 상담 에이전트를 보면, 고객의 질문을 읽고 답을 쓰는 것은 언어 모델이고, 주문 조회 기능을 모델에게 알려 주고 실제로 조회해 결과를 돌려주는 것은 하네스입니다. 에이전트가 언제 일을 시작하고 어디까지 혼자 끝낼 수 있는지는 "AI 에이전트는 스스로 일을 찾아서 하나요?"에서 다룹니다.
하네스에 기능을 많이 넣으면 AI가 더 잘 고르나요?
그렇지 않습니다. 기능의 설명만 읽고 서로 구별할 수 없을 만큼 선택지가 많아지면, AI는 질문에 맞지 않는 기능을 고르기 쉬워집니다.
Anthropic의 개발 문서는 2026년 10월 31일 기준으로, 쓸 수 있는 도구가 30~50개를 넘으면 Claude가 알맞은 도구를 고르는 능력이 떨어진다고 설명합니다(Claude 도구 검색 문서). OpenAI의 개발 문서도 2026년 10월 31일 기준으로, 모델이 한 차례 응답을 시작할 때 쓸 수 있는 함수, 즉 도구를 20개 미만으로 두라고 가볍게 권합니다(OpenAI 함수 호출 문서). Anthropic은 가장 흔한 실패 가운데 하나로 기능을 너무 많이 담았거나 어느 도구를 쓸지에 대한 판단을 모호하게 만드는 도구 묶음을 꼽고, 사람 엔지니어도 어느 도구를 써야 할지 확실히 말하지 못한다면 AI 에이전트가 그보다 잘하기를 기대할 수 없다고 적었습니다(Anthropic, 2025년 9월).
설명을 위해 지어낸 예시로 보겠습니다. 쇼핑몰 상담 AI에 "이 옷 사이즈가 어떻게 되나요?"라는 질문이 들어왔는데, 사이즈 정보 조회와 환불 정보 조회처럼 설명이 비슷한 조회 기능이 20~30개 붙어 있다고 해 봅시다. 설명만으로 어느 기능이 맞는지 가려지지 않으면 AI는 그럴듯한 기능을 아무것이나 고를 수 있고, 같은 질문에도 답이 그때그때 달라질 수 있습니다. 고를 기능이 몇 개뿐이고 설명만으로 확실히 갈린다면, AI가 맞는 기능을 고를 가능성이 높아집니다.
기능이 많을 수밖에 없다면, 모델이 도구 목록을 검색해 필요한 몇 개만 불러오는 도구 검색 기능을 두 회사의 문서가 안내합니다(Claude 도구 검색 문서; OpenAI 함수 호출 문서).
하네스를 잘못 설계하면 어떤 실패가 생기나요?
공개된 사례에 보고된 실패로는 AI가 지켜야 할 규칙을 놓치거나, 읽을 수 없는 곳에 있는 지식을 모른 채 일하거나, 일을 다 끝내기 전에 끝났다고 판단하는 일이 대표적입니다. OpenAI는 초기 진행이 더뎠던 까닭을 Codex의 역량이 아니라 제대로 갖춰지지 않은 환경에서 찾았고, Anthropic은 Claude가 보인 실패 경향을 보완하려고 첫 실행에서 작업 환경을 갖추는 단계와 지시문, 검사 도구를 더했습니다(OpenAI, 2026; Anthropic, 2025년 11월).
- 지침을 파일 하나에 몰아넣었더니 에이전트가 주요 제약을 놓쳤습니다. OpenAI 팀은 에이전트용 안내 파일 AGENTS.md 하나에 지침을 다 담았더니 지침이 작업과 코드, 관련 문서가 들어갈 컨텍스트를 차지했고, 모든 것이 중요하다는 지침은 아무것도 중요하지 않은 지침이 되었으며, 파일은 금세 낡았다고 적었습니다(OpenAI, 2026).
- 읽을 수 없는 지식은 없는 것과 같았습니다. 같은 글은 실행 중에 컨텍스트 안에서 접근할 수 없는 것은 에이전트에게 사실상 존재하지 않는다며, 구글 문서나 채팅 스레드, 사람의 머릿속에 있는 지식을 예로 들었습니다(OpenAI, 2026).
- 에이전트는 이미 있는 패턴을 그대로 따라 했습니다. Codex는 저장소에 있는 패턴을 최적이 아닌 것까지 복제했고, 팀은 한때 일주일의 20%인 매주 금요일을 질 낮은 AI 결과물을 정리하는 데 썼습니다(OpenAI, 2026).
- 에이전트가 한 번에 너무 많이 하려 하거나 일을 너무 일찍 끝냈습니다. Anthropic의 실험에서 긴 작업을 맡은 에이전트는 앱 전체를 한 번에 만들려다 도중에 컨텍스트가 바닥나 반쯤 만든 기능을 기록 없이 남겼습니다. 나중에 시작한 에이전트는 진행된 흔적만 보고 일이 끝났다고 선언했고, 기능이 끝까지 동작하는지 확인하지 않은 채 완료로 표시하는 경향도 보고되었습니다(Anthropic, 2025년 11월).
- 모델이 좋아지자 하네스에 담긴 가정이 낡았습니다. Anthropic은 하네스의 부품마다 모델이 혼자서는 못 한다는 가정이 담겨 있다며, Claude Sonnet 4.5를 위해 넣었던 컨텍스트 초기화(컨텍스트를 비우고 새 에이전트가 정리된 인계 내용을 받아 일을 이어 가게 하는 장치)를 Claude Opus 4.5에서는 뺐다고 밝혔습니다. Sonnet 4.5는 컨텍스트 한도에 가까워졌다고 여기면 일을 서둘러 마무리하는 경향이 강했지만, Opus 4.5에서는 그 경향이 거의 사라졌기 때문입니다(Anthropic, 2026년 3월).
스킬을 잘못 골랐을 때 모델에게 다시 생각하게 하는 것만으로는 바로잡기 어려울 수 있습니다. 스킬 선택을 직접 시험한 연구는 아니지만, 추론 문제에서 외부의 피드백 없이 같은 대화 안에서 언어 모델에게 방금 낸 자기 답을 다시 검토해 고치게 하자, 제대로 고치지 못했고 오히려 성능이 떨어지기도 했다는 연구가 있습니다(Huang 외, 2024).
다만 위 목록의 다섯 가지 실패와 그 대처는 모두 각 회사가 자사 에이전트로 한 실험의 보고입니다. OpenAI도 에이전트가 프롬프트 한 번으로 버그를 재현하고 고친 뒤 검증해 저장소에 반영하기까지 해내는 동작은 그 저장소의 특정 구조와 도구에 크게 기댄 것이라, 적어도 아직은 비슷한 투자 없이 일반화할 수 있다고 가정해서는 안 된다고 적었습니다(OpenAI, 2026).
이 글의 근거와 한계
이 글은 각 회사와 엔지니어가 공개한 기술 글과 개발 문서, 논문 한 편을 바탕으로 정리했고, 인용한 글은 모두 2026년 10월 31일에 원문을 확인했습니다. 성능 수치와 실패 사례는 다른 기관이 다시 확인한 결과가 아닙니다. 쇼핑몰 상담의 두 예는 설명을 위해 지어낸 예시입니다. 하네스라는 말은 최근에야 이런 뜻으로 자리 잡아(Böckeler, 2026) 글마다 가리키는 범위가 조금씩 다릅니다.