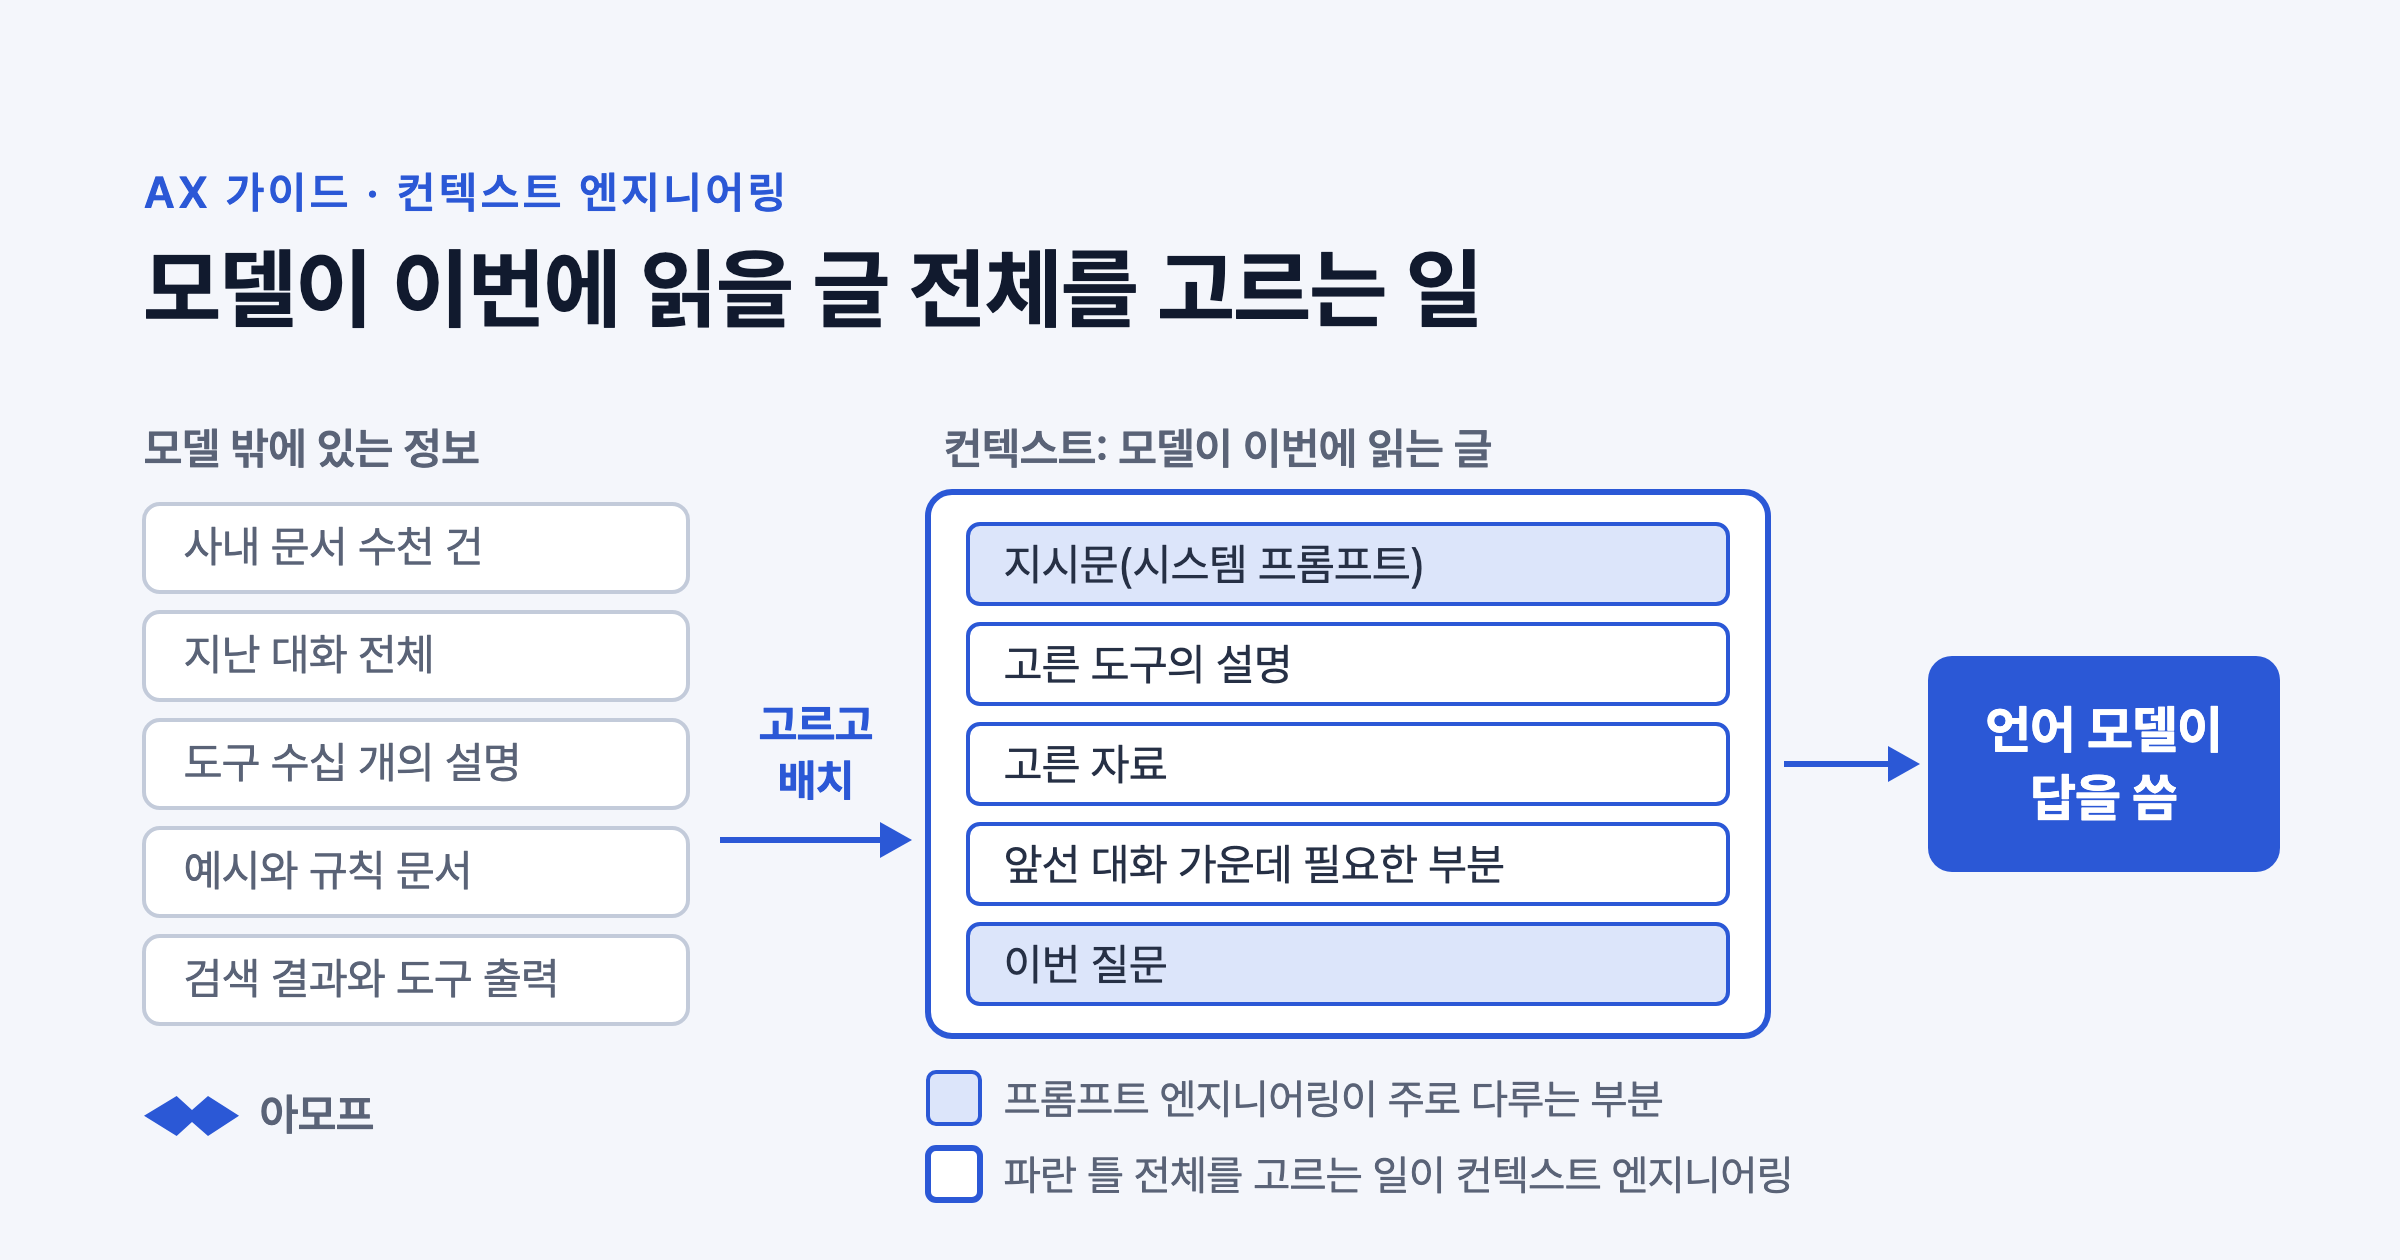
컨텍스트 엔지니어링(context engineering)은 AI 모델이 답을 쓰기 전에 읽을 정보, 즉 지시문과 참고 자료, 도구 설명, 앞선 대화를 고르고 배치하는 일입니다. 질문 문장을 다듬는 프롬프트 엔지니어링보다 다루는 범위가 넓고, 모델을 부를 때마다 무엇을 넣고 뺄지 다시 정한다는 점이 다릅니다.
여기서 AI 모델은 글을 읽고 이어질 글을 만들어 내는 언어 모델을 말하고, 컨텍스트는 모델이 답을 만들 때 함께 읽는 글 전체를 말합니다. AI 모델 Claude를 만드는 Anthropic은 2025년 9월 29일 공개한 글에서 컨텍스트를 언어 모델이 답을 만들 때 넣는 토큰(모델이 글을 잘게 나눠 읽고 쓰는 단위)의 묶음으로, 컨텍스트 엔지니어링을 그 토큰의 가장 알맞은 묶음을 고르고 유지하는 전략으로 정의했습니다(Anthropic, 2025년 9월).
넣는 정보가 많다고 답이 좋아지지는 않습니다. 벡터 데이터베이스 회사 Chroma가 2025년 7월 14일 공개한 보고서에서는, 긴 대화를 기억하는지 묻는 시험 LongMemEval의 질문 306개를 여러 언어 모델에 물었더니, 답에 필요한 부분만 추린 약 300토큰의 입력이 관련 없는 대화까지 담은 약 11만 3천 토큰의 전체 입력보다 시험한 모든 모델에서 뚜렷이 나은 결과를 냈습니다(Chroma, 2025).
컨텍스트 엔지니어링에서는 무엇을 컨텍스트로 넣나요?
컨텍스트로 넣는 것은 모델에게 주는 지시문, 모델이 쓸 수 있는 도구의 설명, 외부에서 가져온 자료, 앞선 대화처럼 모델이 이번 답을 만들 때 읽는 모든 글입니다. Anthropic은 시스템 지시, 도구, MCP(AI가 외부 도구와 자료에 연결되는 방식을 정한 공개 규약), 외부 데이터, 대화 기록을 그 예로 듭니다(Anthropic, 2025년 9월).
시스템 지시는 시스템 프롬프트라고도 하며, 모델에게 매번 먼저 건네는 기본 지시문입니다. 도구는 파일 읽기나 사내 시스템 조회처럼 모델이 불러 쓰는 기능이고, 모델은 도구마다 붙은 설명을 읽고 어떤 도구를 쓸지 고릅니다. 외부 데이터에는 사내 문서에서 찾아온 글이나 도구가 돌려준 결과가 들어갑니다.
이 이름이 널리 쓰이기 시작한 2025년 6월, AI 연구자 안드레이 카르파티(Andrej Karpathy)는 컨텍스트 엔지니어링을 다음 단계에 꼭 맞는 정보로 컨텍스트 윈도우를 채우는 일로 설명하고, 그 재료로 작업 설명과 해설, 몇 가지 예시, RAG로 찾은 자료, 관련 자료, 도구, 작업의 상태와 기록, 압축 등을 꼽았습니다(Willison, 2025). 컨텍스트 윈도우는 모델이 한 번에 다룰 수 있는 글의 한도이고, RAG는 질문과 관련된 문서를 찾아 모델이 함께 읽게 하는 방식입니다.
예시로 설비 담당자가 "펌프의 정비 주기가 얼마인가요?"라고 물었다고 해 봅시다. 프롬프트 엔지니어링은 "답에 근거 문서의 쪽수를 붙여라" 같은 지시문을 다듬는 일입니다. 컨텍스트 엔지니어링은 그 지시문과 함께 펌프 매뉴얼의 어느 판을 넣을지, 지난 정비 기록을 넣을지, 정비 일정을 조회하는 도구의 설명을 넣을지를 고르는 일입니다.
컨텍스트 엔지니어링과 프롬프트 엔지니어링은 무엇이 다른가요?
프롬프트 엔지니어링은 모델에게 주는 지시문을 쓰고 다듬는 일이고, 컨텍스트 엔지니어링은 그 지시문을 포함해 모델이 읽는 정보 전체를 고르는 일입니다. Anthropic은 지시문 쓰기를 따로 떨어진 한 번의 작업으로, 컨텍스트 엔지니어링을 모델에게 무엇을 넘길지 정할 때마다 되풀이하는 작업으로 나누고, 컨텍스트 엔지니어링을 프롬프트 엔지니어링이 자연스럽게 발전한 단계로 봅니다(Anthropic, 2025년 9월).
이 이름은 2025년 6월 전자상거래 플랫폼 Shopify의 CEO 토비 뤼트케(Tobi Lütke)가, 과제를 언어 모델이 풀 수 있을 만큼 필요한 맥락을 모두 건네는 일이 핵심 기술이고 컨텍스트 엔지니어링이라는 말이 그 기술을 더 잘 설명한다고 쓰고, 카르파티가 이에 동의하면서 퍼졌습니다. 개발자 사이먼 윌리슨(Simon Willison)은 많은 사람이 프롬프트 엔지니어링을 챗봇에 글을 입력하는 일 정도로 짐작했다며, 말의 뜻은 사람들이 짐작한 쪽으로 굳는데 컨텍스트 엔지니어링은 짐작한 뜻이 의도한 뜻에 훨씬 가깝다고 보았습니다(Willison, 2025).
지시문을 다듬는 일이 쓸모없어진 것은 아니지만, 어디에나 통하는 지시문 공식은 기대하기 어렵습니다. 2024년 학회 ICLR에서 발표된 연구는 내용은 그대로 두고 구분 기호나 띄어쓰기 같은 형식만 바꿨는데도, 예시 몇 개를 함께 주고 묻는 방식에서 LLaMA-2-13B 모델의 정확도가 최대 76%포인트까지 달라졌다고 보고했습니다. 어떤 형식이 잘 통하는지도 모델끼리 약하게만 일치했습니다(Sclar 외, 2024).
Anthropic도 시스템 프롬프트에서 흔한 실패를 두 가지로 듭니다. 하나는 원하는 동작을 정확히 끌어내려고 복잡하고 깨지기 쉬운 규칙을 지시문에 하나하나 적어 넣는 것이고, 다른 하나는 모델이 따를 구체적인 신호 없이 막연한 방향만 주는 것입니다. 알맞은 지시문은 행동을 이끌 만큼 구체적이면서, 모델이 판단에 쓸 원칙을 줄 만큼 유연해야 한다는 설명입니다(Anthropic, 2025년 9월).
스킬은 컨텍스트와 무엇이 다른가요?
스킬은 특정 작업에 쓸 지시와 자료를 모델 밖에 묶어 둔 꾸러미이고, 컨텍스트는 그 가운데 이번에 모델이 실제로 읽는 부분입니다. Anthropic이 2025년 10월 16일 공개한 에이전트 스킬(Agent Skills)은 지시문과 스크립트, 참고 자료를 정리해 둔 폴더이며, 스킬마다 SKILL.md라는 문서 하나가 중심이 됩니다(Anthropic, 2025년 10월).
스킬은 단계적 공개(progressive disclosure)라는 방식으로 컨텍스트를 아낍니다. 에이전트는 시작할 때 설치된 스킬마다 이름과 짧은 설명만 시스템 프롬프트에 넣어 두고, 지금 일에 맞는 스킬이라고 판단하면 그때 SKILL.md 전체를 읽으며, 딸린 파일은 필요할 때만 열어 봅니다. 그래서 Anthropic은 스킬 하나에 담을 수 있는 내용의 양에 사실상 한계가 없다고 설명하고, 같은 해 12월 18일에는 에이전트 스킬을 여러 제품에서 함께 쓸 수 있는 공개 표준으로 내놓았습니다(Anthropic, 2025년 10월). AI 에이전트는 언어 모델에 도구와 규칙을 묶어, 사람의 요청이나 정해 둔 시각·사건에 따라 여러 단계의 일을 이어 처리하는 프로그램입니다.
다만 처음부터 읽히는 이름과 설명은 스킬이 늘수록 함께 늘어납니다. 설명만 보고 서로 구별되지 않는 선택지가 많아지면 모델이 맞지 않는 것을 고르기 쉬워지는데, 이 문제는 "하네스에 기능을 많이 넣으면 AI가 더 잘 고르나요?"에서 다룹니다.
컨텍스트를 많이 넣을수록 AI의 답이 좋아지나요?
그렇지 않습니다. 컨텍스트에 든 토큰이 늘수록 모델이 그 안의 정보를 정확히 떠올리는 능력은 떨어지며, Anthropic은 이 현상을 컨텍스트 부패(context rot)라고 소개하면서 성능이 어느 길이에서 갑자기 무너지기보다 서서히 낮아진다고 설명합니다(Anthropic, 2025년 9월).
Anthropic은 그 까닭을 모델의 구조에서 찾습니다. 지금의 언어 모델이 쓰는 트랜스포머 구조에서는 모든 토큰이 다른 모든 토큰을 참고할 수 있어 토큰 n개 사이에 n²개의 짝이 생기고, 글이 길어질수록 모델이 이 관계를 제대로 파악하는 능력이 떨어진다는 설명입니다. 그래서 Anthropic은 컨텍스트를 넣을수록 얻는 이득이 줄어드는 한정된 자원으로 보고, 원하는 결과가 나올 가능성을 가장 높이는 가장 작은 토큰 묶음을 찾으라고 권합니다(Anthropic, 2025년 9월).
Chroma의 같은 보고서는 질문과 비슷해 보이지만 답은 아닌 문장, 즉 방해 문장을 하나만 섞어도 성능이 기준보다 떨어졌다고 보고했습니다(Chroma, 2025). 긴 입력의 가운데에 놓인 정보를 앞이나 끝의 정보보다 잘 쓰지 못하는 현상은 "컨텍스트 윈도우란? AI가 긴 대화와 긴 문서에서 놓치는 것"에서 다룹니다.
그래서 무엇을 넣고 뺄지 정하는 일은, 이번 일에서 무엇이 중요한지와 어떤 정보끼리 사실상 같은 내용인지를 정하는 일이 됩니다. 예시로 같은 사내 규정의 2판과 3판이 함께 들어가면, 모델은 어느 판이 지금 유효한지 모른 채 두 판의 문장을 섞어 쓸 수 있습니다. Anthropic이 가장 가볍고 안전한 압축으로 꼽은 도구 결과 지우기도, 대화 기록 깊숙이 남은 도구의 원래 출력을 에이전트가 다시 볼 필요는 없다는 판단에 기댑니다(Anthropic, 2025년 9월).
예시를 넣을 때도 같은 원칙이 적용됩니다. Anthropic은 지켜야 할 예외를 지시문에 줄줄이 늘어놓는 방식을 권하지 않고, 기대하는 동작을 잘 보여 주는 다양하고 대표적인 예시를 골라 넣으라고 권합니다(Anthropic, 2025년 9월).
AI가 필요한 정보를 스스로 찾아 읽게 할 수도 있나요?
네, 할 수 있습니다. 자료를 미리 골라 넣는 대신 파일 경로나 저장해 둔 검색 조건, 웹 링크 같은 가벼운 식별자만 건네고, 모델이 도구로 필요한 내용을 그때그때 찾아 읽게 하는 방식을 Anthropic은 필요한 때에 맞춘(just in time) 방식이라고 부릅니다(Anthropic, 2025년 9월).
Anthropic의 코딩 도구 Claude Code가 이 방식을 씁니다. 큰 데이터베이스를 분석할 때도 데이터 전체를 컨텍스트에 싣지 않고, 파일 이름의 패턴으로 찾는 glob, 글자로 찾는 grep, 파일의 앞부분과 뒷부분만 보는 head와 tail 같은 명령으로 필요한 부분만 찾아 읽습니다. 모델은 이렇게 찾아 읽으며 무엇이 필요한지 단계적으로 알아 갑니다(Anthropic, 2025년 9월).
대가도 있습니다. 실행 중에 찾아 읽는 방식은 미리 계산해 둔 자료를 꺼내는 방식보다 느리고, 안내가 부족하면 에이전트가 도구를 잘못 쓰거나 막다른 길을 쫓느라 컨텍스트를 낭비할 수 있습니다. 그래서 Claude Code는 프로젝트 안내 문서인 CLAUDE.md는 처음부터 컨텍스트에 넣고, 나머지는 필요할 때 찾아 읽게 하는 혼합 방식을 씁니다(Anthropic, 2025년 9월).
문서를 미리 조각으로 나눠 색인해 두고 질문과 가까운 조각을 골라 넣는 RAG는, 모델이 찾아 읽는 방식과 달리 고르는 일을 모델을 부르기 전에 끝내 둡니다. RAG가 답을 만드는 순서는 "RAG란? 검색 증강 생성의 뜻과 작동 순서, 한계"에서 다룹니다.
이 글의 근거와 한계
이 글은 Anthropic의 기술 글 두 편(2025년 9월, 10월)과 Chroma의 기술 보고서(2025), Sclar 외(2024)의 논문, 그리고 이 용어가 퍼진 과정을 정리한 윌리슨의 글(2025)을 바탕으로 정리했고, 인용한 글은 모두 2026년 11월 4일에 원문을 확인했습니다. 제품의 동작과 시험 결과는 각 글이 나온 때의 모델과 버전을 기준으로 하며, 다른 기관이 다시 확인한 결과가 아닙니다. 펌프 정비 질문과 규정 두 판의 예는 설명을 위해 지어낸 예시입니다.