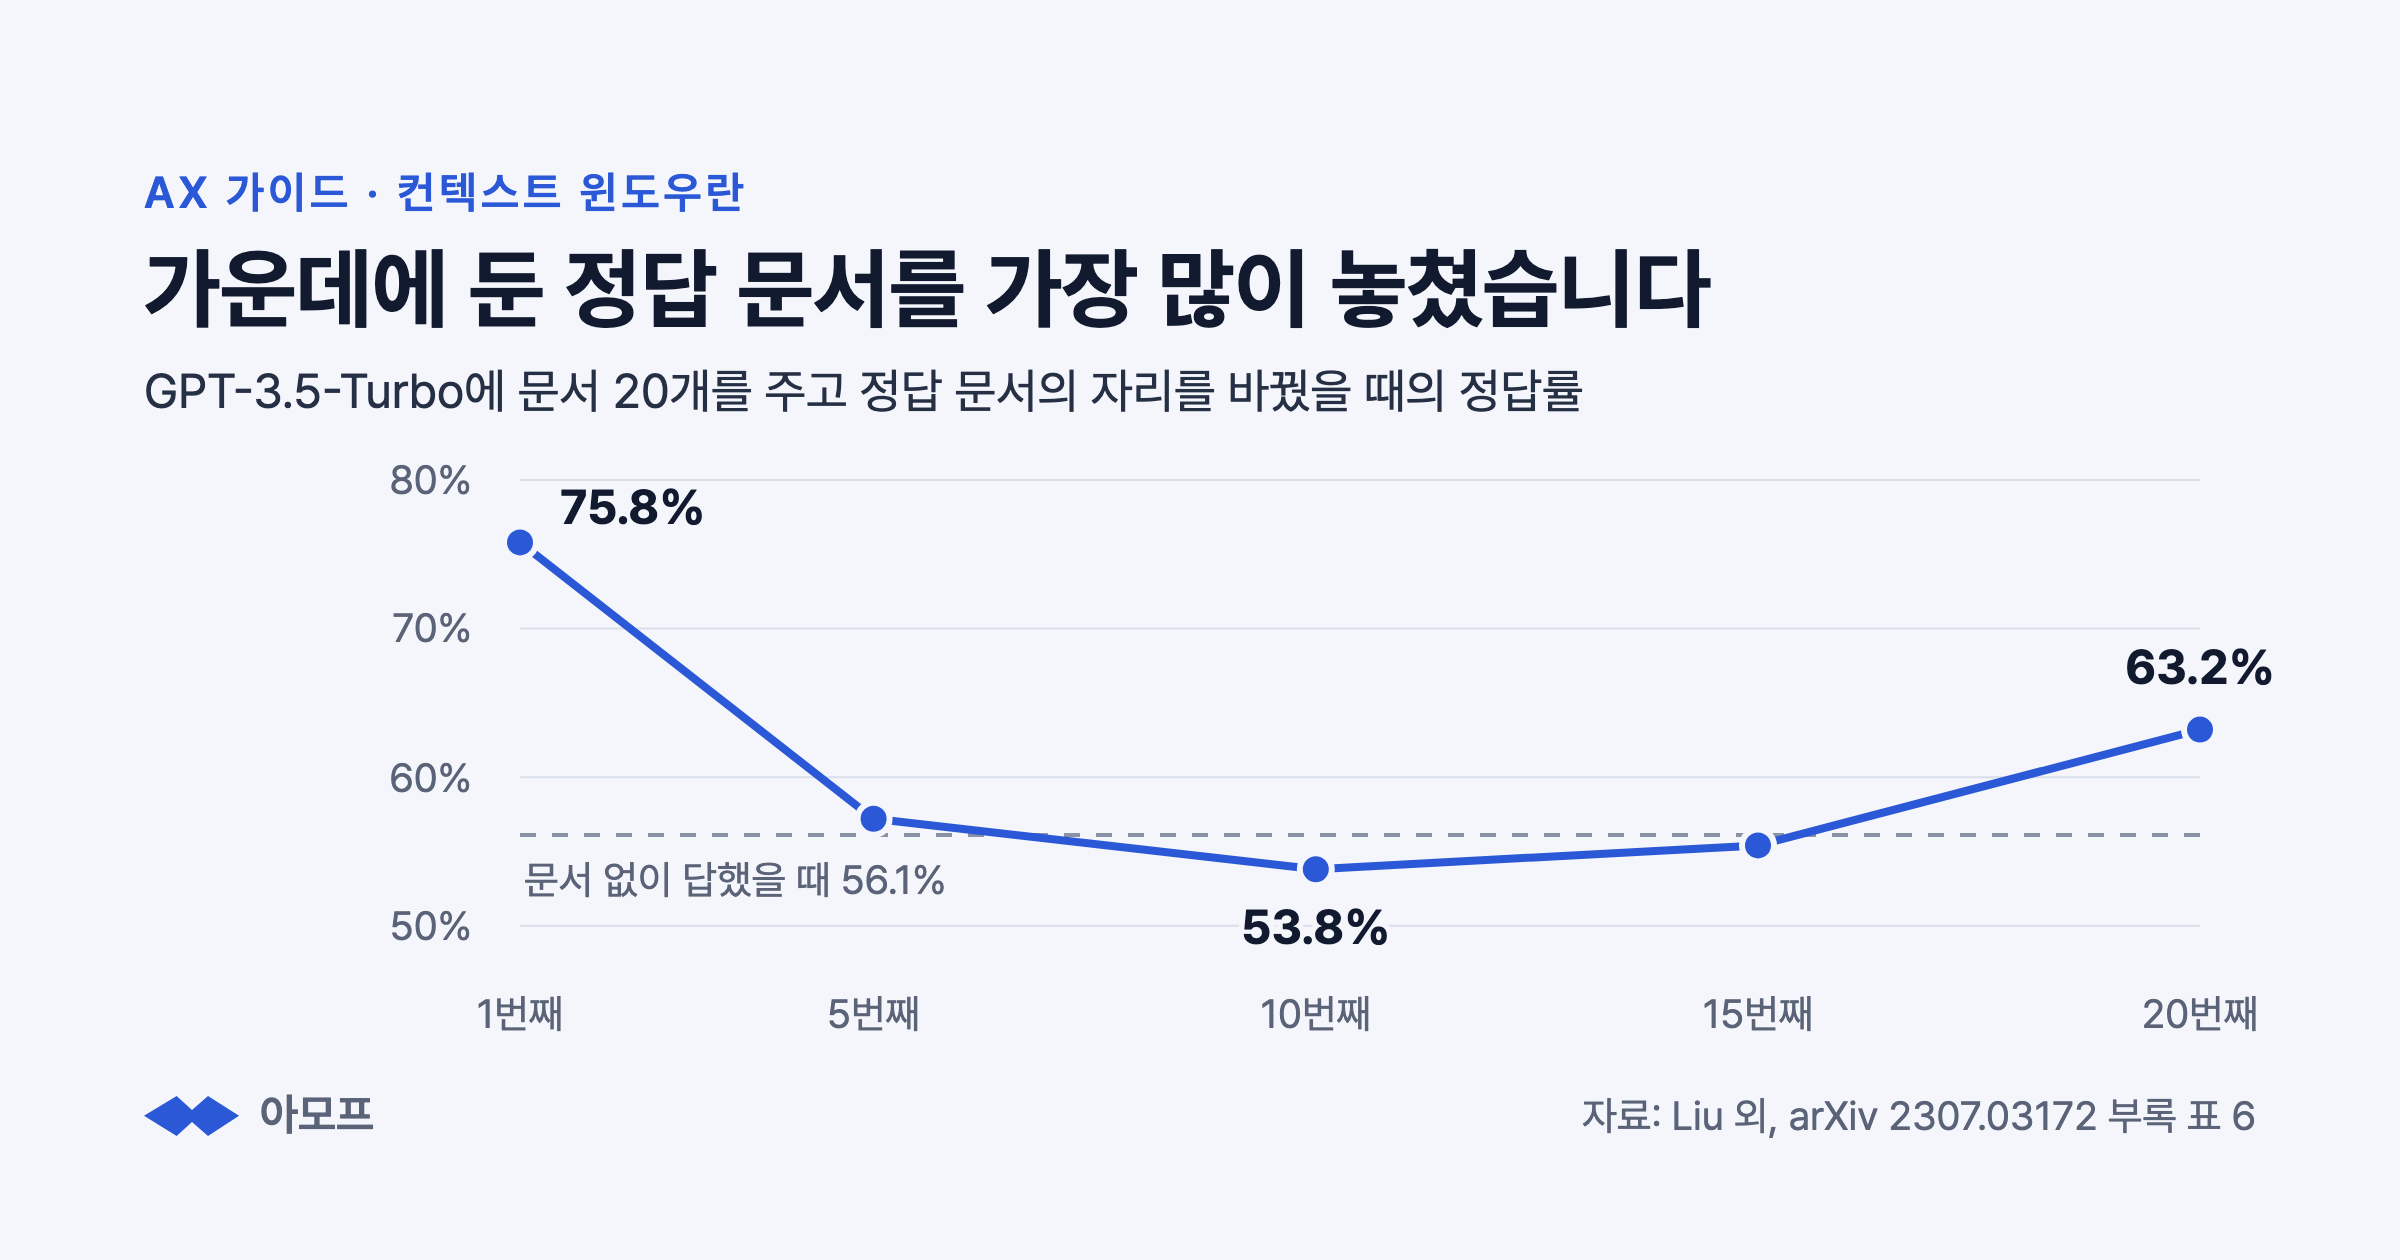
컨텍스트 윈도우는 AI 모델이 답을 쓰는 순간 볼 수 있는 글의 한도이고, 윈도우 밖의 대화와 문서는 모델에게 없는 것과 같습니다. 윈도우 안의 글도 고르게 쓰이지 않아서, 2023년 실험에서 정답이 든 문서를 20개 중 10번째에 두자 GPT-3.5-Turbo의 정답률이 53.8%로 문서 없이 답할 때(56.1%)보다 낮았습니다(Liu 외, 2024).
이 글은 컨텍스트 윈도우(context window)를 재는 단위인 토큰, 대화가 길어질 때 앞의 내용이 사라지는 이유, 긴 입력의 가운데를 놓치는 현상, 지난 대화를 요약해 줄이는 압축이 잃는 것을 차례로 설명합니다. 그리고 할루시네이션(AI가 쓴 답이 실제 사실이나 사용자가 건넨 지시와 자료에 맞지 않는 현상) 가운데 모를 때 추측한 내용을 사실처럼 쓰는 경우처럼, 윈도우로는 설명되지 않는 실수를 따로 나눠 봅니다.
토큰은 무엇이고 컨텍스트 윈도우와 어떤 관계인가요?
토큰은 AI 모델이 글을 잘게 나눠 읽고 쓰는 단위이고, 컨텍스트 윈도우의 크기는 이 토큰의 개수로 정해집니다. 같은 글이 몇 토큰이 되는지는 언어와 모델마다 달라서, 크기가 같은 윈도우라도 담기는 글의 양이 다릅니다.
토큰 하나는 낱말 하나일 수도 있고, 낱말의 일부나 글자 하나일 수도 있습니다. 글을 토큰으로 자르는 규칙을 토크나이저라고 하는데, Anthropic은 Claude 4.7 이후 모델의 새 토크나이저가 같은 글을 이전 모델보다 약 30% 많은 토큰으로 나눈다고 밝혔습니다(Claude 문서). Google은 Gemini 모델에서 100토큰이 영어 낱말 60~80개쯤이라고 안내합니다(Google 문서).
영어를 중심으로 만든 토크나이저에서는 같은 내용이라도 한국어가 토큰을 더 많이 씁니다. 위키백과 문장 2,000개를 200개 언어로 옮긴 자료로 잰 2023년 연구에서, 당시 ChatGPT와 GPT-4가 쓰던 토크나이저는 한국어 문장에 같은 뜻의 영어 문장보다 2.38배 많은 토큰을 썼습니다. 연구진은 이런 차이가 서비스 비용과 처리 시간, 모델에게 건넬 수 있는 글의 양에도 영향을 준다고 지적했습니다(Petrov 외, 2023).
윈도우를 차지하는 것은 질문만이 아닙니다. 시스템 프롬프트(대화 전에 모델에게 주는 지시문)와 지난 대화, 첨부한 이미지와 문서, 도구(모델이 불러 쓰는 검색이나 계산 같은 기능)의 정의와 결과, 그리고 모델이 그 차례에 쓰는 출력까지 모두 윈도우에 들어갑니다(Claude 문서). 이미지도 토큰으로 세어서, Google은 가로와 세로가 모두 384픽셀 이하인 이미지 한 장을 258토큰으로 셉니다(Google 문서).
대화가 길어지면 AI가 앞의 내용을 잊는 이유는 무엇인가요?
모델이 기억을 잃어서가 아니라, 윈도우 한도에 가까워지면 모델을 부르는 대화 프로그램이 오래된 대화를 빼거나 요약해서 보내기 때문입니다. 윈도우 안에 남은 대화도 길어질수록 모델이 덜 정확하게 활용하는데, 이 현상은 다음 소제목에서 다룹니다. 모델은 요청마다 받은 글만 보고, 지난 대화를 모아 다시 보내는 일은 대화 프로그램이 맡습니다.
Anthropic의 API(프로그램이 모델을 부르는 창구) 문서는 API가 앞선 요청을 기억하지 않으므로 대화 기록 전체를 매번 보내야 한다고 설명합니다(Claude 문서). OpenAI의 문서도 요청 하나하나가 서로 독립적이며 상태를 저장하지 않는다고 적고, 대화를 이어 가려면 지난 메시지를 함께 보내거나 API가 대화 상태를 대신 저장해 두는 기능을 쓰도록 안내합니다(OpenAI 문서). 이렇게 모델을 감싸서 부르고 대화 기록과 도구를 관리하는 프로그램을 하네스라고 하며, 자세한 뜻은 "하네스 엔지니어링이란? 뜻과 설계 대상, 대표적인 실패"에서 다룹니다.
윈도우가 차면 무엇을 남길지는 하네스가 정합니다. Claude의 컨텍스트 윈도우 문서에 따르면 API는 입력만으로 윈도우를 넘는 요청을 처리하지 않고 오류를 돌려주며, claude.ai 같은 채팅 화면은 먼저 들어온 대화부터 내보내는 방식으로 윈도우를 관리할 수도 있습니다. 오래된 대화를 버리는 대신 요약으로 바꿔 넣는 압축 기능도 있습니다(Claude 문서). 어느 쪽이든 모델이 다음 답을 쓸 때 보는 것은 하네스가 남긴 글뿐입니다.
긴 문서의 가운데를 놓친다는 「Lost in the Middle」은 사실인가요?
네, 조건을 통제한 실험에서 확인된 현상입니다. 필요한 정보가 입력의 맨 앞이나 맨 끝에 있을 때 정답률이 가장 높고 가운데로 갈수록 떨어져서, 자리별 정답률을 이으면 U자 모양이 됩니다(Liu 외, 2024).
문서 20개(약 4천 토큰)를 넣었을 때 GPT-3.5-Turbo의 정답률은 정답이 든 문서가 1번째이면 75.8%, 10번째이면 53.8%, 20번째이면 63.2%였습니다(Liu 외, 2024). 스탠퍼드 대학 등의 연구진은 질문 하나와 위키백과에서 뽑은 짧은 문서 여러 개를 함께 주고, 정답이 든 문서 하나의 자리만 바꿔 가며 정답률을 쟀습니다. 2023년에 공개되어 2024년 학술지 TACL에 실린 이 논문의 제목은 「Lost in the Middle: How Language Models Use Long Contexts」입니다.
윈도우가 큰 모델이 이 현상을 피한 것도 아닙니다. 입력이 두 윈도우에 모두 들어갈 때, 윈도우가 4천 토큰인 GPT-3.5-Turbo와 1만 6천 토큰인 GPT-3.5-Turbo(16K)는 자리별 정답률이 거의 겹쳤습니다. 검색해 넣은 문서를 20개에서 50개로 늘려도 정답률은 GPT-3.5-Turbo가 약 1.5%, Claude-1.3이 약 1% 오르는 데 그쳤습니다(Liu 외, 2024). 관련 자료를 찾아 질문과 함께 넣는 방식인 RAG에서도 근거를 많이 넣는다고 답이 꼭 좋아지지는 않는 이유입니다.
연구진은 모델의 구조, 질문을 문서 앞뒤에 함께 두는 방식, 지시를 따르도록 하는 추가 학습이 원인인지 예비 조사로 살폈습니다. 이 추가 학습을 거치기 전의 기본 모델도 U자 모양을 보였고, 연구진은 이 모양을 사람이 목록의 처음과 끝 항목을 가장 잘 기억하는 심리학의 계열 위치 효과에 견주었습니다(Liu 외, 2024). 실험한 모델은 2023년 모델이지만, 2026년 10월 31일에 확인한 Claude 문서도 토큰이 늘수록 정확도와 재현율(넣어 둔 정보를 찾아내는 정도)이 떨어지는 현상을 컨텍스트 부패(context rot)라고 부르며, 윈도우에 글을 많이 넣는다고 자동으로 더 좋아지는 것은 아니라고 적습니다(Claude 문서).
컨텍스트 압축은 대화가 길어질 때 무엇을 잃나요?
압축은 오래된 대화를 요약 한 덩어리로 바꾸므로, 요약에 들지 못한 세부는 그 뒤의 대화에서 모델이 다시 볼 수 없습니다. Anthropic은 압축을 지나치게 하면 중요성이 나중에야 드러나는 미묘하지만 중요한 맥락을 잃을 수 있다고 설명합니다(Anthropic, 2025).
컨텍스트 압축(compaction)은 대화가 윈도우 한도에 가까워졌을 때 지난 대화를 요약하고, 그 요약으로 새 윈도우를 시작하는 일입니다(Anthropic, 2025). 모델이 알아서 하는 일이 아니라 하네스나 API가 모델에게 요약을 요청하고 그 요약으로 지난 대화를 대신하는 기능이며, Claude API에도 오래된 턴(사용자와 모델이 한 번씩 주고받는 차례)을 서버에서 쓴 요약으로 바꾸는 베타 기능이 있습니다. Claude의 압축 문서는 최근 몇 턴을 원문 그대로 남기는 방식과, 기본 요약이 뒤에 필요한 내용을 빠뜨릴 때 요약 지시문을 직접 쓰는 방식도 안내합니다(Claude 문서).
무엇이 남을지는 요약의 기준이 정합니다. Anthropic의 코딩 에이전트(코드를 대신 쓰고 고치는 AI 프로그램)는 압축할 때 설계 결정과 해결하지 못한 버그, 구현의 세부는 남기고 중복된 도구 출력과 메시지는 버립니다(Anthropic, 2025).
이 손실은 책을 요약하며 긋는 밑줄에 빗대어 볼 수 있습니다. 요약하는 모델이 책 전체를 꿰뚫는 문장이라서 긋는 밑줄과 설명이 마음에 들어서 긋는 밑줄을 같은 무게로 다루면, 요약에는 무엇을 다뤘는지만 남고 왜, 어떻게, 무엇이 달랐는지는 빠질 수 있습니다. 이 비유는 압축 기능이 실제로 무엇을 고르는지 잰 결과가 아닙니다.
컨텍스트 윈도우로 설명되지 않는 AI의 실수는 무엇인가요?
할루시네이션 가운데 모를 때 추측한 내용을 사실처럼 쓰는 경우와, 학습이 끝난 뒤에 생긴 사실을 모르는 문제는 윈도우의 크기나 자리로 설명되지 않습니다. 두 실수의 원인은 윈도우 밖, 곧 모델을 학습시키고 평가하는 방식과 학습 자료가 끝나는 시점에 있습니다.
2025년 9월에 공개된 연구는 사전 학습(대량의 글로 다음 낱말을 예측하게 하는 첫 학습)을 거친 모델의 할루시네이션이 참과 거짓을 가르는 분류의 오류에서 생기고, 학습과 평가가 모른다고 답하기보다 추측하는 쪽에 점수를 주기 때문에 사라지지 않는다고 분석했습니다(Kalai 외, 2025). 원인과 문서 업무에서 나타나는 모양은 "할루시네이션이란? AI 환각의 뜻과 원인, 문서 업무에서 나타나는 모양"에서 다룹니다.
모델이 아는 사실에도 끝이 있습니다. Anthropic은 모델마다 지식이 가장 넓고 믿을 만한 마지막 시점과 학습에 쓴 자료의 범위를 따로 적어 둡니다(Claude 문서). 그 뒤의 사실은 질문과 함께 윈도우에 넣어 줘야 모델이 쓸 수 있으며, 관련 자료를 찾아 함께 넣는 RAG가 이 일을 합니다.
윈도우에 들어가기 전에 생기는 실수도 있습니다. 아모프 창업팀이 2026년 9월 24일 논문 한 편을 PDF와 학술지 XML(논문의 제목, 절, 표를 구조째 담는 파일 형식)로 각각 읽었을 때, PDF에서는 표의 한 줄이 숫자만 이어진 글 조각이 되고 열의 머리글은 다른 조각으로 떨어졌지만 XML에서는 표 11개가 행과 열 그대로 남았습니다(논문 PDF의 표와 AI). 구조가 풀린 채 들어간 표는 윈도우를 넓혀도 원래의 행과 열로 돌아오지 않습니다.
정리하면 대화와 입력이 길어서 생기는 실수는 윈도우로 설명되지만, 학습과 평가 방식이나 학습 자료가 끝나는 시점, 구조가 풀린 표에서 생기는 실수는 윈도우로 설명되지 않습니다. 여섯 가지를 나란히 놓으면 다음과 같습니다.
| 실수 | 생기는 자리 | 윈도우로 설명되나요 |
|---|---|---|
| 긴 대화의 앞부분을 잊음 | 하네스가 오래된 대화를 빼거나 요약함 | 예 |
| 긴 입력의 가운데에 놓인 근거를 놓침 | 입력 안의 자리에 따라 정보를 쓰는 정도가 다름 | 예 |
| 압축한 뒤 세부를 잃음 | 요약에 들지 못한 내용이 지워짐 | 예 |
| 모를 때 추측한 내용을 사실처럼 씀 | 학습과 평가 방식 | 아니요 |
| 학습 뒤에 생긴 사실을 모름 | 학습 자료가 끝나는 시점 | 아니요 |
| 표의 값이 어느 열의 값인지 모름 | 윈도우에 들어가기 전에 풀린 표 구조 | 아니요 |
입력 토큰과 출력 토큰의 값은 왜 다르게 매기나요?
가격표가 이유를 밝히지는 않지만, 출력 토큰은 모델이 하나씩 차례로 만들어야 해서, 한꺼번에 계산하는 입력 토큰보다 시간이 오래 걸리고 계산 장치(GPU)도 효율적으로 쓰지 못합니다(Kwon 외, 2023). 2026년 10월 31일 Anthropic의 가격표에서는 실린 모든 Claude 모델의 출력 단가가 입력 단가의 5배였습니다(Claude 가격표).
입력은 모든 토큰이 미리 주어져 있어 한꺼번에 계산하지만, 출력은 앞서 만든 토큰에 기대어 다음 토큰을 만들므로 여러 단계를 동시에 계산할 수 없고 요청 하나에 걸리는 시간의 대부분을 차지합니다(Kwon 외, 2023). OpenAI의 지연 시간 안내서도 출력 토큰을 절반으로 줄이면 지연 시간이 절반쯤 줄어들 수 있지만, 아주 긴 문서나 이미지를 넣는 경우가 아니라면 입력을 절반으로 줄여도 지연 시간은 1~5%쯤 줄어드는 데 그칠 수 있다고 설명합니다(OpenAI 문서).
다른 회사의 가격표도 출력이 비쌌습니다. 같은 날 백만 토큰당 가격으로 Google의 Gemini 2.5 Pro는 입력이 20만 토큰 이하일 때 입력 1.25달러, 출력 10달러로 8배였고, OpenAI의 gpt-5.6-terra는 입력이 27만 2천 토큰 이하일 때 표준 요금이 입력 2달러, 출력 12달러로 6배였습니다(Google 가격표, OpenAI 가격표). 답을 내기 전에 모델이 생각하며 만드는 토큰도 출력 토큰으로 청구됩니다(Claude 문서).
윈도우와 비용은 함께 움직입니다. API가 앞선 요청을 기억하지 않으므로 대화가 길어질수록 매 요청에 지난 대화가 다시 입력 토큰으로 들어가 청구됩니다. 자주 되풀이되는 앞부분을 저장해 두고 싸게 다시 읽는 프롬프트 캐싱은 그 토큰의 값을 낮출 뿐, 윈도우에서 차지하는 자리는 줄이지 않습니다(Claude 문서).
근거와 한계
윈도우의 동작과 압축, 토큰, 가격은 2026년 10월 31일에 확인한 Anthropic, OpenAI, Google의 공식 문서와 가격표를 따랐으며, 가격과 모델 목록은 바뀔 수 있습니다. 자리에 따른 정답률은 2023년 모델로 한 실험(Liu 외, 2024)이라 지금 모델의 수치는 다를 수 있고, 언어별 토큰 수의 차이(Petrov 외, 2023)도 당시 토크나이저로 잰 값입니다. 밑줄 비유는 설명을 위한 비유이며 측정 결과가 아닙니다. 2026년 9월 24일의 관찰은 아모프 창업팀이 공개 논문 한 편을 PDF와 학술지 XML로 각각 읽어 직접 비교한 것으로, 실제 회사의 업무에 쓴 결과가 아닙니다.